Artykuł · 29.10.2026
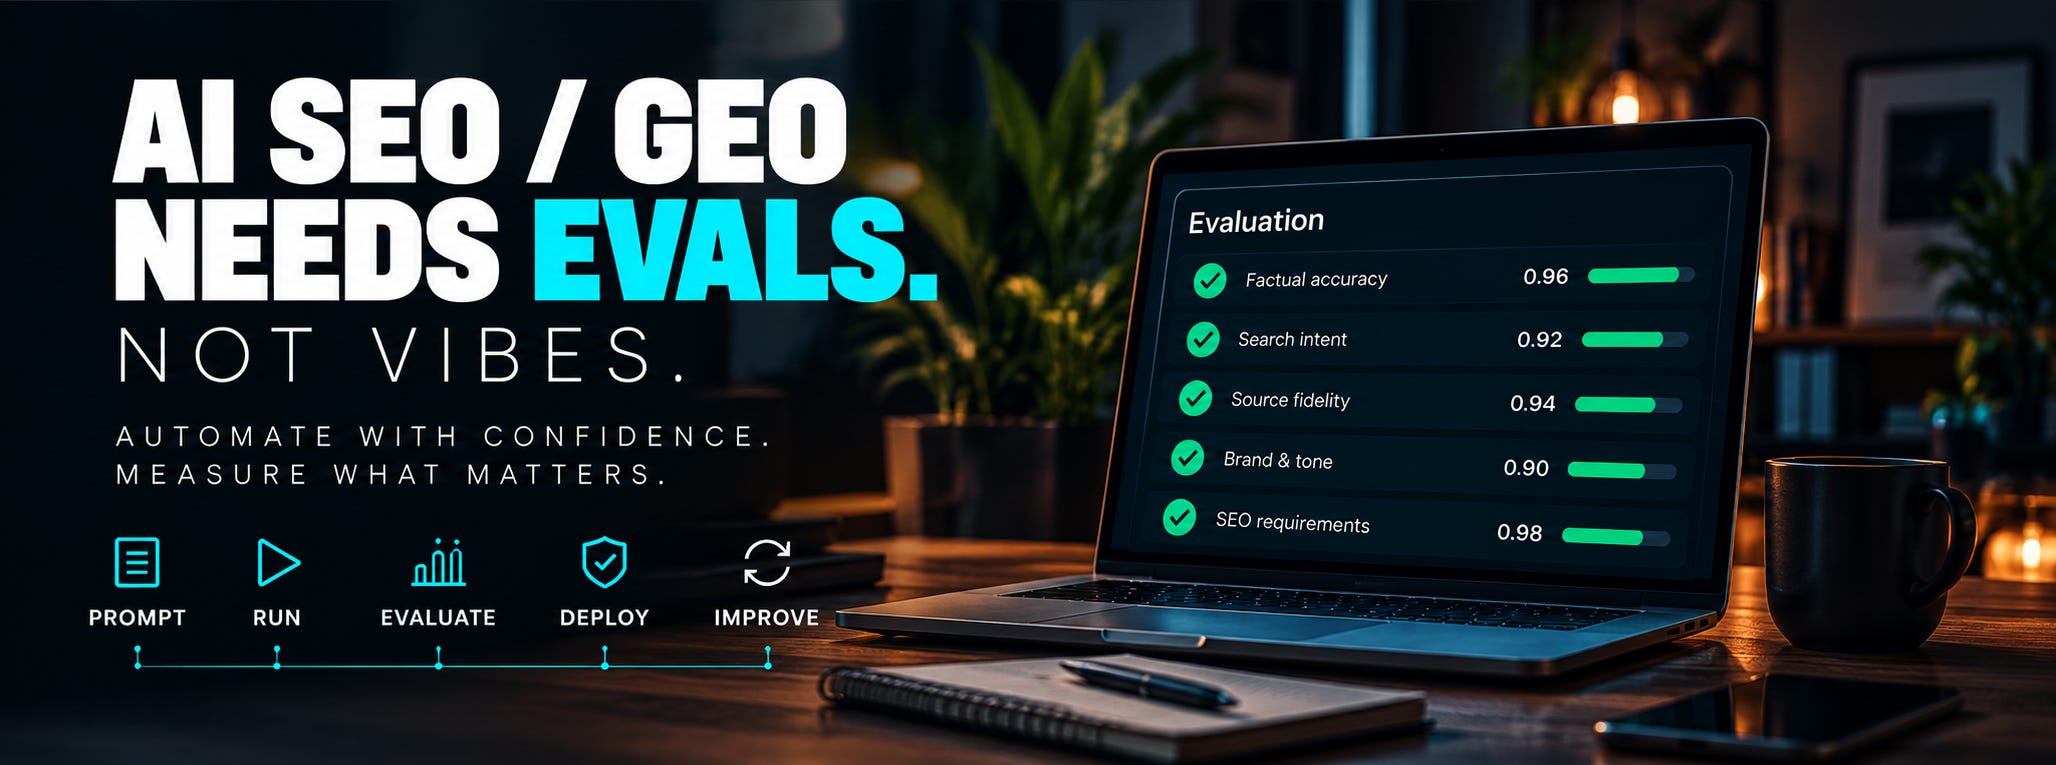
Automatyzacja SEO z AI potrzebuje ewaluacji, nie intuicji
Praktyczny model ewaluacji automatyzacji SEO/GEO: zgodność z faktami i źródłami, zachowanie wartości treści, kalibracja ocen i kryteria wdrożenia z Langfuse.
W tym artykule
Jeśli AI tworzy lub aktualizuje treści SEO albo podejmuje decyzje dotyczące tych treści, ewaluacja powinna stać się częścią modelu operacyjnego.
Zespoły SEO szybko przechodzą od AI jako asystenta pisania do budowania całych procesów
- Przygotowanie briefu treści.
- Przeredagowanie strony kategorii.
- Odświeżenie nieaktualnego artykułu.
- Stworzenie setek opisów produktów.
- Zaproponowanie linków wewnętrznych.
- Klasyfikacja adresów URL.
- Identyfikacja luk w treści.
- Generowanie metadanych.
- Decyzja, czy istniejącą stronę zaktualizować, połączyć z inną, czy pozostawić bez zmian.
A coraz częściej:
powierzenie wewnętrznemu agentowi automatycznego wykonania kilku z tych kroków.
Potencjał jest oczywisty.
Problem jakości już mniej.
Jeśli proces wykorzystujący AI generuje 50 000 wyników, przejrzenie kilku przykładów i stwierdzenie:
Wygląda to całkiem dobrze.
nie jest systemem kontroli jakości.
To dobór próby na wyczucie.
Gdy AI zaczyna na dużą skalę zmieniać treści w środowisku produkcyjnym, zespoły SEO/GEO potrzebują czegoś bliższego testowaniu oprogramowania.
Potrzebują ewaluacji.
Samo generowanie nie jest już najtrudniejsze
Podstawowe generowanie treści stało się w dużej mierze powszechnie dostępną funkcją.
Większość współczesnych modeli potrafi przygotować:
- czytelny tekst
- nagłówki
- metadane
- podsumowania
- opisy kategorii
- szkice FAQ
- opisy produktów
- struktury artykułów
Ciekawszym problemem jest niezawodność.
Co się stanie, gdy zmienisz:
- model
- prompt
- pobrany kontekst
- dokumenty źródłowe
- narzędzia
- logikę kierowania zadań
- parametr temperature
- skill agenta
- kolejność kroków procesu?
Czy jakość się poprawi?
A może jeden wymiar się poprawił, a inny po cichu pogorszył?
To istotne, ponieważ wyniki aplikacji opartych na LLM są z natury zmienne.
Przegląd ewaluacji Langfuse opisuje ewaluację jako powtarzalny sposób pomiaru zachowania aplikacji LLM: zarówno offline, przed wdrożeniem, jak i online, na rzeczywistych śladach wykonania ze środowiska produkcyjnego. Ten model łączy ślady wykonania, zbiory danych, eksperymenty, mechanizmy oceniające i monitoring produkcji.
Bardzo dobrze pasuje to do automatyzacji SEO.
Obserwowalność i ewaluacja to różne rzeczy
To ważne rozróżnienie.
Obserwowalność pyta:
Co się wydarzyło?
Ewaluacja pyta:
Czy to, co się wydarzyło, było dobre?
Załóżmy, że wewnętrzny agent SEO aktualizuje artykuł.
Ślad wykonania może nam pokazać, że:
- Pobrał aktualną wersję artykułu.
- Odpytał wewnętrzną bazę wiedzy.
- Pobrał dane z Search Console.
- Wygenerował nową wersję.
- Przesłał stronę do CMS.
To cenna informacja.
Langfuse
Według przeglądu ewaluacji Langfuse śledzenie wykonania może rejestrować wywołania modeli i narzędzi, pobrany kontekst, dane wejściowe i wyjściowe, opóźnienia, koszty oraz obserwacje z poszczególnych etapów procesu.
Sam ślad wykonania nie powie jednak, czy aktualizacja była dobra.
Do tego potrzebna jest ewaluacja.
Czy agent:
- zachował oryginalną wiedzę ekspercką?
- wprowadził błąd merytoryczny?
- usunął ważny link wewnętrzny?
- zmienił nazwę produktu?
- wymyślił statystykę?
- nadpisał świadomie zoptymalizowany nagłówek?
- poprawił dopasowanie do intencji użytkownika?
- sprawił, że artykuł stał się bardziej ogólnikowy?
- zaktualizował właściwy adres URL?
To osobna warstwa.
Dlaczego ma to szczególne znaczenie dla SEO/GEO
Jakość w SEO jest wielowymiarowa.
Rzadko istnieje jedna prosta definicja:
poprawnego wyniku.
Wyobraź sobie aktualizację wygenerowaną przez AI, która poprawia czytelność o 20%.
Świetnie.
Ale załóżmy, że przy okazji:
- usuwa oryginalne badania
- zmienia nazwę encji
- gubi trzy istotne linki wewnętrzne
- dodaje niepoparte źródłami twierdzenie
- sprawia, że tekst staje się bardziej ogólnikowy
- zmienia znaczenie specyfikacji produktu
Czy aktualizacja poprawiła tekst?
Raczej nie.
Dlatego jeden ogólny „wskaźnik jakości treści” nie wystarcza.
W procesach SEO/GEO oceniałbym osobno kilka wymiarów.
1. Zgodność z faktami i poprawność danych o encjach
Treść powinna poprawnie przedstawiać fakty, na których się opiera.
W zależności od typu strony może to oznaczać:
- nazwę produktu
- cenę
- dostępność
- specyfikację
- lokalizację
- sprzedawcę
- warunki świadczenia usługi
- daty
- osoby
- organizacje
- twierdzenia zawarte w źródłach
Jeżeli proces otrzymuje wiarygodne dane źródłowe, kontrola faktów powinna w miarę możliwości porównywać z nimi wygenerowany wynik.
Przy ustrukturyzowanych danych wejściowych często można to zrobić deterministycznie.
Jeśli katalog będący źródłem prawdy podaje:
price = €89
a wygenerowana treść mówi:
€99
nie potrzebujesz kolejnego LLM, aby ustalić, czy wynik jest poprawny.
Test powinien po prostu zakończyć się niepowodzeniem.
2. Wierność źródłom
Staje się to szczególnie ważne, gdy agenci prowadzą research przed utworzeniem lub aktualizacją treści.
Powinniśmy zapytać:
Czy każde istotne twierdzenie ma oparcie w źródłach dostępnych w procesie?
To coś innego niż pytanie, czy tekst brzmi wiarygodnie.
Idealnie płynny artykuł może zawierać niepoparte źródłami stwierdzenia.
W pracy GEO opartej na rozbudowanym researchu sprawdzałbym zwłaszcza, czy proces rozróżnia:
- potwierdzone informacje
- obserwacje
- interpretacje
- hipotezy
- kwestie nierozstrzygnięte
To znacznie bliższe temu, jak powinien wyglądać research prowadzony przez człowieka.
3. Intencja użytkownika i intencja wyszukiwania
Wynik może być zgodny z faktami, a mimo to nie realizować zadania.
Załóżmy, że użytkownik oczekuje:
porównania dwóch platform e-commerce dla przedsiębiorstw
ale agent przygotowuje:
ogólne wprowadzenie do e-commerce.
Tekst da się przeczytać.
W praktyce jest bezużyteczny.
Mechanizm oceniający powinien sprawdzać, czy strona rzeczywiście zaspokaja zamierzoną potrzebę informacyjną i realizuje swój cel.
4. Własna, unikalna wartość
To coraz ważniejsze przy wykorzystywaniu AI na dużą skalę.
Wytyczne Google dotyczące treści tworzonych z generatywną AI wskazują, że AI może wspierać research i opracowywanie struktury, ale automatyczne tworzenie dużych ilości stron bez dodawania wartości może naruszać zasady dotyczące nadużywania treści na dużą skalę. Google zaleca też skupienie się na poprawności, jakości i trafności oraz ręczne sprawdzanie faktów w treściach wygenerowanych przez AI.
Pytanie ewaluacyjne nie powinno więc brzmieć:
Czy to jest poprawne gramatycznie?
Powinno brzmieć:
Czy ten proces wniósł coś użytecznego?
Na przykład:
- oryginalne dane firmy
- interpretację ekspercką
- własne informacje o produktach
- własne badania
- lepsze wyjaśnienie
- wartościowe porównanie
- trafne przykłady
- aktualne informacje
Moja interpretacja tych wytycznych Google jest taka, że nacisk pada na wartościowe treści, które nie powielają powszechnie dostępnych informacji, zamiast na produkowanie kolejnych wersji tego, co już jest wszędzie.
5. Zachowanie wartości podczas aktualizacji
Ten wymiar często umyka uwadze.
- Wygenerowanie nowego artykułu to jedno zadanie.
- Aktualizacja istniejącego artykułu to inne zadanie.
- Agent aktualizujący treść nie powinien oceniać wyłącznie tego, co dodał.
- Powinien też oceniać to, co zniszczył.
Wyobraź sobie artykuł zawierający:
- wypowiedzi ekspertów
- oryginalne dane
- ręcznie opracowane przykłady
- wnioski właściwe dla danego biznesu
- starannie dobrane linki wewnętrzne
Model otrzymuje polecenie:
Zaktualizuj ten artykuł na 2027 rok.
- Pięknie przepisuje całość.
- I usuwa połowę unikalnej wartości.
- Powierzchowna kontrola jakości może uznać nowy artykuł za doskonały.
Ewaluacja uwzględniająca zmiany powinna odrzucić taki wynik.
Dlatego w procesach aktualizacji testowałbym wprost:
Wskaźnik zachowania wartości
Czy zachowaliśmy wartościowe informacje, które nadal były poprawne?
Poprawność modyfikacji
Czy zmieniliśmy tylko informacje, które rzeczywiście wymagały aktualizacji?
Bezpieczeństwo usuwania treści
Czy proces usunął istotne informacje bez uzasadnienia?
Tutaj ewaluacja powinna obejmować diff, czyli różnice między wersjami, a nie tylko końcowy tekst.
6. Standardy marki i standardy redakcyjne
To dobre obszary do zastosowania LLM-as-a-judge, czyli oceny przez model.
Na przykład:
- odpowiedni ton
- poziom dopasowany do doświadczonych odbiorców
- terminologia
- niedozwolone sformułowania
- przesadny entuzjazm
- nieuzasadniona pewność
- czytelność
- zgodność ze stylem redakcyjnym
Dokumentacja Langfuse dotycząca LLM-as-a-judge opisuje mechanizmy, w których inny model ocenia wynik według określonych kryteriów. Można je stosować w kontrolowanych eksperymentach lub do obserwacji ze środowiska produkcyjnego.
Wymaga to jednak kalibracji.
Sędzią jest kolejny model.
Nie jest on źródłem obiektywnej prawdy.
LLM-as-a-judge jest przydatny, ale nie wystarcza
Modele oceniające są wartościowe, ponieważ wiele pytań o jakość treści ma charakter subiektywny.
Wyrażenie regularne nie odpowie wiarygodnie na pytanie:
Czy ten artykuł wnosi użyteczną perspektywę ekspercką?
LLM może ocenić to skuteczniej.
Ale oceny automatyczne należy porównywać z ocenami ludzi.
Wytyczne OpenAI dotyczące ewaluacji zalecają kalibrowanie automatycznej oceny względem ocen przypisanych przez ludzi i ostrzegają przed „vibe-based evals”, czyli ewaluacją na wyczucie. Zalecają też konkretne kryteria związane z zadaniem zamiast nadmiernie ogólnych metryk.
Dlatego połączyłbym trzy warstwy.
Deterministyczne mechanizmy oceny
Używaj kodu tam, gdzie istnieje obiektywna odpowiedź.
Przykłady:
- wymagany tytuł istnieje
- adres URL jest poprawny
- obowiązkowe sekcje istnieją
- cena produktu zgadza się z katalogiem
- wynik jest poprawnym JSON-em
- linki wewnętrzne są poprawne
- niedozwolone domeny nie występują
- chronione sekcje nie zostały usunięte
- wymagane odwołania do źródeł istnieją
- limity znaków są zachowane
Langfuse obsługuje mechanizmy oceny oparte na kodzie, przeznaczone do walidacji deterministycznej i reguł biznesowych.
Ocena przez LLM
Używaj LLM-as-a-judge tam, gdzie potrzebna jest interpretacja znaczenia.
Przykłady:
- realizacja intencji
- użyteczność
- wierność źródłom
- twierdzenia bez oparcia w źródłach
- ton
- jasność przekazu
- zachowanie ważnych informacji
- to, czy aktualizacja rzeczywiście poprawia treść
Ocena przez ludzi
Ludzie powinni ustalać wzorzec poprawności i kontrolować obszary, w których błędy mają istotne konsekwencje.
Przykłady:
- artykuły o znaczeniu strategicznym
- tematy prawne lub medyczne
- kluczowe strony kategorii
- treści wrażliwe z punktu widzenia marki
- nowe typy procesów
- rozbieżności między mechanizmami oceny
Opinie ludzi powinny też służyć do kalibracji samego automatycznego mechanizmu oceniającego.
Oceniaj agenta, nie tylko końcowy tekst
Staje się to jeszcze ważniejsze, gdy automatyzacja SEO przechodzi od pojedynczego wywołania LLM do agenta.
Wyobraź sobie wewnętrznego agenta aktualizującego treści.
Jego proces może wyglądać tak:
- Wybór adresu URL do rozważenia
- Pobranie istniejącej treści
- Zebranie danych o wynikach
- Pobranie aktualnych informacji źródłowych
- Decyzja, co powinno się zmienić
- Wygenerowanie zmian
- Walidacja wyniku
- Przekazanie proponowanej zmiany
Końcowy tekst może wyglądać poprawnie, nawet jeśli sposób dochodzenia do niego jest ryzykowny.
W procesach agentowych oceniałbym między innymi następujące kwestie.
Wybór narzędzi
Czy agent wywołał właściwe narzędzie?
Wybór źródeł
Czy skorzystał ze źródła rozstrzygającego, zamiast ze słabszej alternatywy?
Zakres
Czy zaktualizował wskazany adres URL?
Jakość decyzji
Czy aktualizacja była rzeczywiście potrzebna?
Zachowanie wartości
Czy zachował istniejące unikalne informacje?
Obsługa błędów
Czy zatrzymał się, gdy źródło było niedostępne?
Eskalacja
Czy poprosił człowieka o weryfikację, gdy poziom pewności był niewystarczający?
W odniesieniu do procesów agentowych wytyczne OpenAI dotyczące ewaluacji wspierają podobne podejście: wykorzystanie śladów wykonania do sprawdzania wyboru narzędzi, przekazywania zadań, zgodności z zasadami i zachowania całego procesu, a następnie przenoszenie reprezentatywnych przypadków do powtarzalnych zbiorów danych i testów ewaluacyjnych.
Wynik końcowy jest tylko jedną częścią systemu.
Jak zbudowałbym to z Langfuse
Praktyczna pętla ewaluacji SEO/GEO mogłaby wyglądać następująco.
Krok 1: Rejestruj cały przebieg
Każde zautomatyzowane zadanie SEO otrzymuje jeden ślad wykonania.
Na przykład:
update-category-page
W ramach tego śladu:
- pobranie źródeł
- zapytanie do Search Console
- sprawdzenie katalogu
- wykonanie promptu
- wygenerowanie treści
- walidacja
- działanie w CMS
Powstaje w ten sposób historia umożliwiająca audyt.
Krok 2: Zbuduj reprezentatywny zbiór danych
Nie twórz ręcznie 20 idealnych przykładów testowych, uznając, że praca jest skończona.
Wykorzystaj rzeczywiste scenariusze.
Dokumentacja zbiorów danych Langfuse opisuje zbiory, które mogą zawierać dane wejściowe do testów i oczekiwane wyniki. Ślady wykonania z produkcji można przekształcać w przykłady w zbiorze danych.
Dla SEO uwzględniłbym:
- typowe strony
- strony z nieaktualnymi faktami
- strony, których NIE należy zmieniać
- strony z niewielką ilością treści
- bardzo długie strony
- strony ze sprzecznymi źródłami
- strony przeznaczone na rynki międzynarodowe
- produkty z niedostępnymi wariantami
- strony z wartościowymi oryginalnymi badaniami
- przypadki wcześniejszych niepowodzeń
Ta ostatnia kategoria jest kluczowa.
Każde istotne niepowodzenie w produkcji powinno stać się przyszłym testem regresji.
Krok 3: Ustal punkt odniesienia
Uruchom aktualny proces produkcyjny na zbiorze danych.
Zmierz:
- zgodność z faktami
- zachowanie wartości
- dopasowanie do intencji
- użyteczność
- styl
- koszt
- opóźnienie
Otrzymasz punkt odniesienia.
Bez niego „lepiej” jest głównie opinią.
Krok 4: Testuj każdą istotną zmianę
Załóżmy, że zmieniamy:
- model GPT
- model Claude
- prompt systemowy
- logikę pobierania informacji
- narzędzie agenta
- szablon treści
Uruchom proponowaną wersję na tym samym zbiorze danych.
Eksperymenty Langfuse służą do porównywania zmian promptów, modeli i aplikacji na powtarzalnych zbiorach danych.
Następnie porównaj:
wersję produkcyjną z proponowaną wersją
A nie:
nowy wynik z naszym wspomnieniem starego.
Krok 5: Zdefiniuj kryteria dopuszczenia do wdrożenia
Niektóre błędy powinny blokować wdrożenie.
Na przykład:
factual_accuracy < 0.98 → FAIL
protected_content_preserved = false → FAIL
unsupported_claims > threshold → FAIL
intent_score < 4/5 → REVIEW
W ten sposób jakość przestaje być tylko informacją na pulpicie, a staje się podstawą decyzji o wdrożeniu.
Langfuse obsługuje uruchamianie eksperymentów w CI i blokowanie procesów wdrożeniowych po naruszeniu progów ewaluacji.
W tym momencie ewaluacje stają się częścią infrastruktury inżynieryjnej.
Krok 6: Wersjonuj prompty
Prompty nie powinny być niewidocznymi ciągami znaków rozrzuconymi po plikach Pythona.
Langfuse Prompt Management obsługuje niezmienne wersje promptów, etykiety środowisk oraz wycofanie zmiany przez przeniesienie etykiety produkcyjnej na wcześniejszą wersję.
W systemie automatyzacji SEO pozwala to odpowiedzieć:
- Który prompt wygenerował tę aktualizację strony?
- Którego modelu użyto?
- Która wersja spowodowała regresję?
- Co zmieniło się między tymi dwiema wersjami?
Taka identyfikowalność staje się bardzo ważna wraz ze wzrostem skali automatyzacji.
Krok 7: Oceniaj działanie w produkcji
Zbiory danych offline nigdy nie obejmą wszystkiego.
W produkcji ujawnią się nowe rodzaje błędów.
Langfuse obsługuje ocenę bieżących obserwacji, w tym próbkowanego ruchu produkcyjnego, za pomocą mechanizmów opartych na kodzie, modeli oceniających lub ocen dostarczanych z zewnątrz.
Dobra pętla wygląda więc tak:
- Ślad wykonania z produkcji
- Wykrycie błędu
- Weryfikacja przez człowieka
- Dodanie przypadku do zbioru danych
- Poprawa promptu, agenta lub pobierania informacji
- Uruchomienie eksperymentu
- Wdrożenie tylko po przejściu zestawu testów regresji
Wartość ewaluacji narasta z każdą taką iteracją.
System stopniowo uczy się, co oznacza „źle” w konkretnej organizacji.
Co powinny mierzyć zespoły SEO?
Nie poprzestawałbym na ogólnym wskaźniku jakości.
Przy procesach SEO wspomaganych AI użyteczne metryki operacyjne mogą obejmować:
- odsetek wyników przechodzących kontrolę faktów
- odsetek twierdzeń bez oparcia w źródłach
- odsetek udanych aktualizacji
- wskaźnik zachowania wartości
- odsetek akceptacji przez człowieka
- średnią odległość edycyjną między wynikiem a wersją poprawioną przez człowieka
- odsetek regresji
- koszt zaakceptowanego wyniku
- opóźnienie
- odsetek eskalacji
- odsetek odrzuceń przy publikacji
Po wdrożeniu nadal powinniśmy mierzyć rzeczywiste wyniki biznesowe:
- wartościowy ruch
- konwersje
- przychody
- zaangażowanie
- przejścia z systemów AI
- ścieżki zakupowe z udziałem kanałów wspomagających
Nie należy jednak mylić tych metryk biznesowych z ewaluacją modelu.
Wzrost ruchu nie dowodzi niezawodności procesu opartego na LLM.
A idealny wynik ewaluacji nie gwarantuje wzrostu ruchu.
Te pomiary odpowiadają na różne pytania.
Model operacyjny jest ważniejszy niż narzędzie
Langfuse jest przydatny, ponieważ zapewnia infrastrukturę do:
- śledzenia wykonania
- zarządzania promptami
- tworzenia zbiorów danych
- eksperymentów
- przyznawania ocen
- ręcznego oznaczania przykładów
- oceny przez LLM
- monitorowania produkcji
- ewaluacji w CI/CD
Ale narzędzie nie decyduje, co oznacza „dobra treść SEO”.
To pozostaje odpowiedzialnością organizacji.
- SEO musi zdefiniować intencję wyszukiwania i potrzeby użytkownika.
- Specjaliści od treści muszą zdefiniować jakość redakcyjną.
- Zespoły produktowe i komercyjne muszą określić wymagania biznesowe.
- Zespoły danych muszą wskazać wiarygodne fakty stanowiące punkt odniesienia.
- Inżynierowie muszą określić ograniczenia możliwe do sprawdzenia deterministycznie.
- Następnie te oczekiwania trzeba przekształcić w mechanizmy oceny.
- Na tym polega rzeczywista zmiana.
- Wiedza organizacji staje się wykonywalną kontrolą jakości.
Moja interpretacja
Pierwszy etap wykorzystania AI w SEO sprowadzał się do pytania:
Czy AI potrafi to napisać?
Drugi etap:
Czy możemy to zautomatyzować?
Dojrzalsze pytanie brzmi:
Czy potrafimy udowodnić, że zautomatyzowany system staje się lepszy, a nie tylko produkuje więcej?
W enterprise SEO/GEO to rozróżnienie ma ogromne znaczenie.
Wygenerowanie 100 stron jest łatwe.
Wygenerowanie 100 000 stron staje się coraz łatwiejsze.
Znacznie trudniej wiedzieć, że zmiana promptu, modelu lub procesu nie pogorszyła 10% z nich.
Do tego służą ewaluacje.
Każdego agenta SEO wykorzystywanego do poważnych zadań traktowałbym jak system produkcyjny:
- Rejestruj jego działanie.
- Wersjonuj go.
- Testuj go.
- Oceniaj go.
- Porównuj wyniki.
- Monitoruj go.
- Dodawaj nieudane przypadki do zbioru danych.
Gdy AI zaczyna tworzyć i aktualizować treści na dużą skalę, ograniczeniem przestaje być samo generowanie.
Staje się nim pewność, że system działa właściwie.
Źródła
- Langfuse: przegląd ewaluacji: langfuse.com/docs/evaluation/overview
- Langfuse: zbiory danych: langfuse.com/docs/evaluation/experiments/datasets
- Langfuse: LLM-as-a-Judge: langfuse.com/docs/evaluation/evaluation-methods/llm-as-a-judge
- Langfuse: zarządzanie promptami: langfuse.com/docs/prompt-management/overview
- OpenAI: dobre praktyki ewaluacji: developers.openai.com/api/docs/guides/evaluation-best-practices
- Google: wytyczne dotyczące treści tworzonych z generatywną AI: developers.google.com/search/docs/fundamentals/using-gen-ai-content
Wymieńmy się doświadczeniami
Jak to wygląda w Twojej praktyce?
Która z tych zmian już wpływa na pracę Twojego zespołu? Podziel się doświadczeniem na LinkedIn lub przeczytaj powiązaną notatkę na Substacku.