Artykuł · 25.10.2026
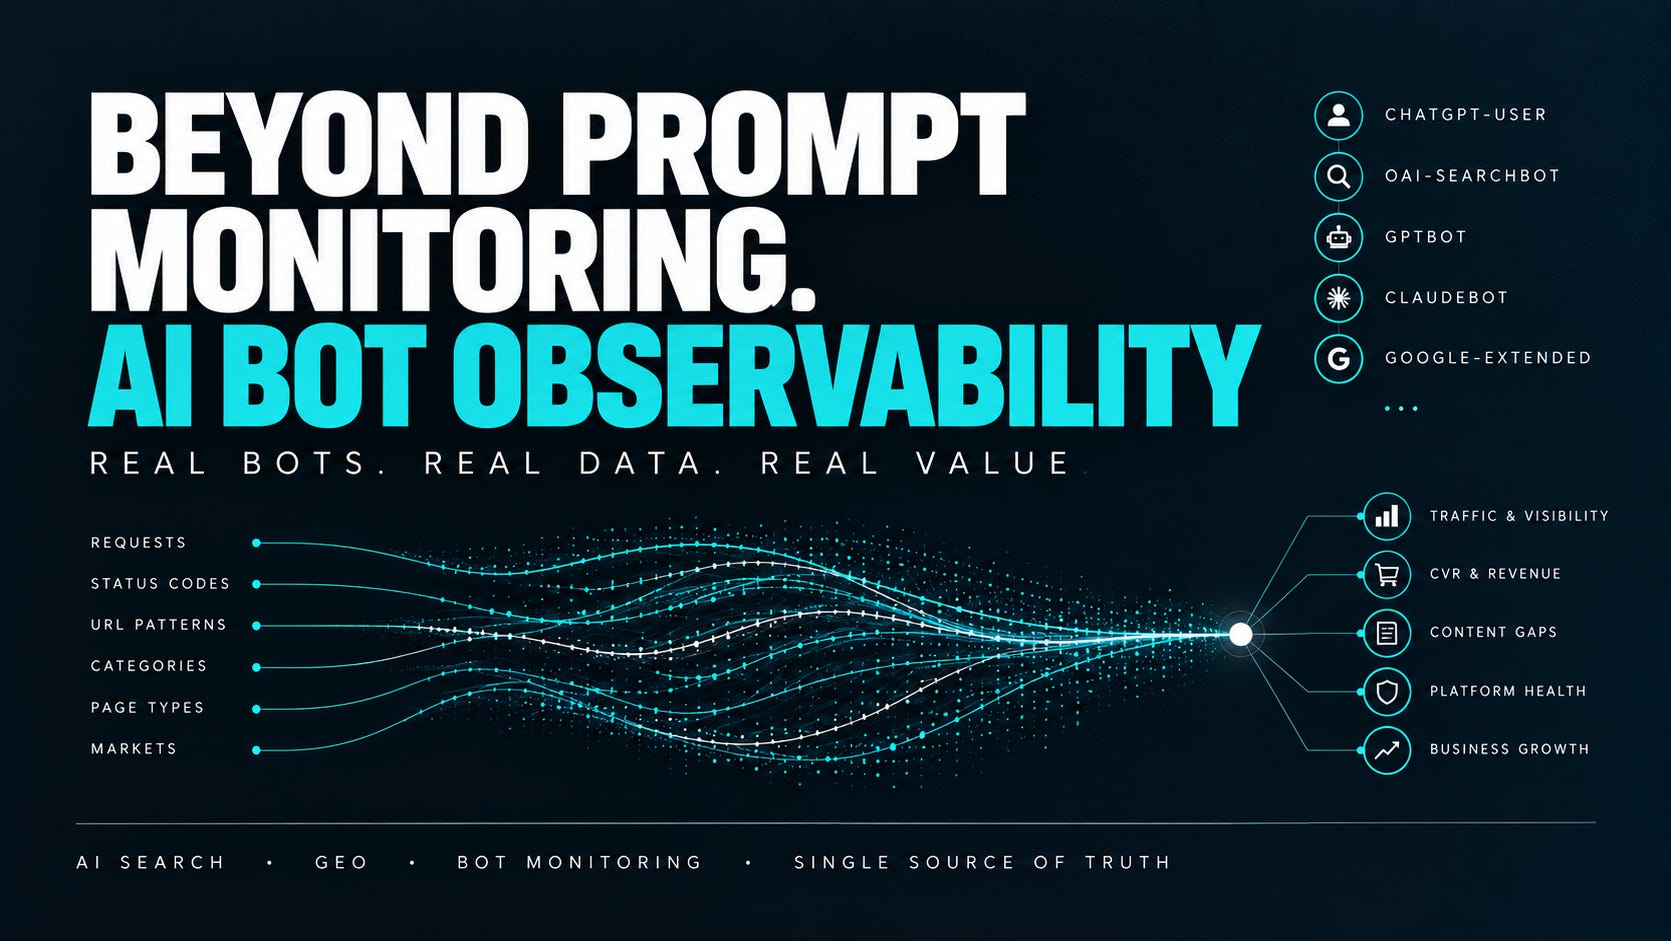
Więcej niż monitorowanie promptów: dlaczego obserwowalność botów AI ma znaczenie dla SEO i GEO
Połącz żądania poszczególnych botów, odpowiedzi HTTP i taksonomię e-commerce z widocznością w AI oraz danymi biznesowymi, zachowując ostrożność w ocenie przyczyn.
W tym artykule
Dlaczego obserwowalność botów AI ma znaczenie dla SEO i GEO.
W poprzednim artykule pisałem o problemie z monitorowaniem promptów AI
Jeden prompt nie odzwierciedla rzeczywistej ścieżki użytkownika.
Monitorowanie promptów i sesji w przeglądarce pomaga zrozumieć, co rekomendują systemy AI, z jakich źródeł korzystają i jak ich odpowiedzi zmieniają się w trakcie rozmowy.
Jest jednak jeszcze jedna warstwa, którą moim zdaniem zespoły SEO i GEO w dużych organizacjach powinny monitorować znacznie uważniej:
aktywność botów AI.
Nie raz w miesiącu.
Nie przez okazjonalny eksport logów serwera.
I zdecydowanie nie jako jeden wykres zatytułowany „crawlery AI”.
W dużej platformie e-commerce monitorowanie botów AI powinno stać się warstwą obserwowalności: działającą niemal w czasie rzeczywistym, z podziałem na segmenty i poszczególne boty, połączoną z danymi biznesowymi.
🤖 Nie każdy bot AI oznacza to samo
To prawdopodobnie najważniejszy punkt wyjścia.
Zgodnie z dokumentacją crawlerów OpenAI, już w samym ekosystemie OpenAI możemy wyróżnić kilka różnych celów:
- OAI-SearchBot wspiera wyszukiwanie i pomaga uwzględniać witryny w funkcjach wyszukiwania ChatGPT.
- ChatGPT-User może pobierać strony w wyniku działania użytkownika w ChatGPT lub Custom GPT.
- GPTBot jest związany z treściami, które mogą zostać wykorzystane do trenowania modeli.
To różne sygnały.
Nagły wzrost liczby żądań ChatGPT-User może być interesujący, ponieważ ten agent wiąże się z aktywnością inicjowaną przez użytkowników.
Nie oznacza to jednak automatycznie:
„Ruch z ChatGPT wzrósł o 30%”.
Żądania mogą wskazywać na częstsze pobieranie treści z naszej domeny w wyniku działań użytkowników, ale nadal potrzebujemy danych o ruchu z poleceń, danych analitycznych i komercyjnych, by zrozumieć, co wydarzyło się później.
To samo dotyczy OAI-SearchBot.
Wzrost może wskazywać, że OpenAI pobiera więcej naszych treści na potrzeby związane z wyszukiwaniem.
Nie dowodzi, że uzyskaliśmy więcej cytowań, rekomendacji czy przychodów.
To fundamentalne rozróżnienie.
Dokumentacja crawlerów Anthropic opisuje podobny podział na ClaudeBot, Claude-SearchBot i Claude-User.
Nie każdy ekosystem działa jednak dokładnie tak samo. Na przykład Google opisuje Google-Extended jako token sterujący w robots.txt, który nie ma własnego ciągu HTTP User-Agent.
Nawet stwierdzenie „monitoruj każdy bot AI osobno” wymaga więc technicznego doprecyzowania:
Monitoruj osobno każdy możliwy do zidentyfikowania crawler lub user agent i rozumiej, jakie informacje faktycznie udostępnia jego dostawca.
📈 Kody odpowiedzi to pierwsza warstwa, a nie kompletny dashboard
Najprostszy użyteczny monitoring zaczyna się od odpowiedzi HTTP.
Dla każdego istotnego bota chcę znać:
- liczbę żądań w czasie,
- odpowiedzi 2xx,
- przekierowania,
- błędy 404 i pozostałe odpowiedzi 4xx,
- odpowiedzi 403 i 429,
- błędy 5xx,
- hosty, których dotyczą żądania,
- grupy adresów URL, których dotyczą żądania.
Nawet proste anomalie mogą być wartościowe.
Nagły wzrost liczby odpowiedzi 5xx może ujawnić problem z dostępnością dotykający konkretnego crawlera.
Skok liczby odpowiedzi 403 lub 429 może wskazywać, że reguły bezpieczeństwa lub ograniczania liczby żądań utrudniają dostęp.
Rosnąca liczba błędów 404 może wskazywać na nieaktualne adresy URL, zmienioną architekturę lub zewnętrzne odwołania do treści, które już nie istnieją.
Duży wzrost liczby odpowiedzi 200 również może być interesujący.
Nie nazwałbym go jednak automatycznie pozytywnym.
Może oznaczać częstsze crawlowanie stron ważnych biznesowo.
Może też oznaczać wielokrotne crawlowanie bezwartościowych adresów z parametrami.
Kontekst zmienia interpretację.
Dokumentacja Cloudflare AI Crawl Control opisuje podobny model: aktywność poszczególnych crawlerów, ścieżki, operatorów i rozkład kodów odpowiedzi HTTP.
W przypadku dużej platformy poszedłbym dalej.
🔎 E-commerce potrzebuje monitorowania na poziomie taksonomii
Łączna liczba żądań ChatGPT-User czy Claude-SearchBot nie wystarczy.
Chcę wiedzieć, do czego uzyskują dostęp.
Na przykład:
- Elektronika → Smartfony → Samsung
- Uroda → Pielęgnacja włosów
- Podróże → Hotele → Hiszpania
- Usługi → Masaż → Chicago
Nagły wzrost aktywności crawlerów AI w obrębie adresów związanych ze smartfonami Samsung może być interesującym sygnałem.
Jest jednak istotne ograniczenie:
logi serwera zwykle pokazują żądany adres URL, a nie oryginalny prompt użytkownika.
Dlatego powiedziałbym:
„Widzimy rosnącą aktywność botów AI wokół treści o smartfonach Samsung”.
A nie:
„Użytkownicy częściej pytają ChatGPT o «smartfon Samsung»”.
Ten drugi wniosek wymaga dodatkowych dowodów.
W e-commerce segmentowałbym zachowanie botów według schematu:
rynek → jednostka biznesowa → kategoria → podkategoria → typ strony → encja → URL.
To może pokazać, w których częściach platformy systemy AI aktywnie pobierają treści, gdzie aktywność maleje i gdzie prawie nic nie jest pobierane.
Ta ostatnia grupa bywa szczególnie interesująca.
- Dlaczego ważna biznesowo kategoria niemal nie odnotowuje aktywności crawlerów AI?
- Czy trudno ją odkryć?
- Czy linkowanie wewnętrzne jest słabe?
- Czy treść jest niedostępna?
- Czy sekcja jest celowo zablokowana?
- A może crawler po prostu nie ma powodu, by ją pobierać?
Monitoring wskazuje pytanie.
Nie dostarcza automatycznie odpowiedzi.
🚨 Comiesięczne eksporty logów nie wystarczą
Ręczna analiza logów nadal jest przydatna.
Korzystam z niej przy pogłębionych badaniach i analizie zdarzeń po fakcie.
Jednak w dużym e-commerce eksport kilku dni logów raz na kilka miesięcy nie jest modelem operacyjnym.
Zbudowałbym monitoring działający niemal w czasie rzeczywistym, z alertami.
Przykłady:
🚨 Odsetek odpowiedzi 5xx dla OAI-SearchBot przekracza poziom bazowy.
🚨 ChatGPT-User nagle otrzymuje odpowiedzi 403 w obrębie jednego rynku.
🚨 Aktywność Claude-SearchBot spada niemal do zera.
🚨 Crawlery AI zaczynają odpytywać miliony mało wartościowych adresów URL z parametrami.
🚨 Ważna biznesowo kategoria traci większość aktywności crawlerów po wdrożeniu.
🚨 Liczba żądań dotyczących jednej rodziny produktów nagle znacząco rośnie.
Właściwy próg będzie inny dla każdej platformy.
Najważniejsze, by informacja o anomalii docierała do zespołu w momencie jej wystąpienia, a nie kilka tygodni później podczas audytu SEO.
🛡️ Czasem problem SEO leży poza warstwą SEO
To obszar, który uważam za szczególnie interesujący w dużych organizacjach.
Crawler może mieć zezwolenie w robots.txt, a mimo to być blokowany gdzie indziej.
Między crawlerem AI a aplikacją mogą znajdować się:
CDN → ochrona DDoS → WAF → zarządzanie botami → load balancer → reverse proxy → aplikacja.
Reguła w dowolnym miejscu tego łańcucha może zmienić wynik.
Cloudflare wprost opisuje przypadki, w których wcześniejsze reguły WAF mogą blokować crawlery AI, mimo że w pozostałej konfiguracji mają one zezwolenie na dostęp.
OpenAI publikuje również zakresy adresów IP swoich crawlerów.
To prowadzi do istotnego pytania operacyjnego:
Czy intencje zapisane w robots.txt odpowiadają temu, co boty faktycznie otrzymują na brzegu sieci?
Moim zdaniem to obszar współpracy zespołów technicznego SEO/GEO, bezpieczeństwa, sieci i inżynierii platformy.
Sam audyt robots.txt nie odpowie na to pytanie.
🧠 Szersza koncepcja: zbuduj jedno źródło prawdy
Aktywność botów staje się znacznie bardziej wartościowa, gdy przestaje funkcjonować w osobnym dashboardzie.
Dla każdego znormalizowanego adresu URL, a najlepiej również dla stojącej za nim encji, połączyłbym kilka warstw danych.
Na przykład:
Warstwa botów
- żądania OAI-SearchBot,
- żądania ChatGPT-User,
- żądania GPTBot,
- boty Claude,
- rozkład kodów odpowiedzi HTTP,
- częstotliwość crawlowania.
Widoczność w wyszukiwarkach i AI
- wyświetlenia i kliknięcia w Google/Bing,
- pozycje,
- cytowania i wzmianki w AI,
- ruch z poleceń AI.
Biznes
- sesje,
- współczynnik konwersji (CVR),
- zamówienia,
- GMV,
- przychody,
- marża,
- powtórne zakupy / lojalność.
Platforma
- rynek,
- kategoria,
- typ strony,
- kanoniczny adres URL,
- identyfikatory produktów, usług i sprzedawców,
- dostępność.
Wtedy zmienia się pytanie.
Zamiast:
„Które adresy URL crawlował OAI-SearchBot?”
możemy zapytać:
„Które kategorie o wysokich przychodach i dużej lojalności klientów są niedostatecznie reprezentowane w crawlowaniu przez AI i widoczności w AI?”
Albo:
„Gdzie wzrost aktywności ChatGPT-User wystąpił razem ze wzrostem ruchu z poleceń AI i wyników komercyjnych?”
Albo:
„Które strony generują istotną wartość biznesową, ale zwracają błędy crawlerom AI?”
To znacznie bliższe temu, jak moim zdaniem powinna działać współczesna analityka SEO/GEO.
Jedno ważne zastrzeżenie:
łączenie tych zbiorów danych nie dowodzi związku przyczynowego.
Aktywność botów, widoczność w AI, ruch i przychody mogą zmieniać się równolegle z wielu powodów.
Wartością jednego źródła prawdy jest lepsza diagnoza i ustalanie priorytetów, a nie tworzenie pozornego modelu atrybucji.
🧩 Monitorowanie botów to tylko jedna warstwa
To bezpośrednio łączy się z moim poprzednim artykułem o monitorowaniu promptów.
Nie budowałbym strategii pomiaru AI Search wokół jednego zbioru danych.
Połączyłbym kilka warstw:
1. Obserwowalność botów
Co systemy AI pobierają z naszej infrastruktury?
2. Monitorowanie widoczności w wyszukiwarkach i AI
Gdzie jesteśmy pokazywani, cytowani lub rekomendowani?
3. Ocena ścieżki użytkownika
Co dzieje się w realistycznych, wieloetapowych rozmowach i przy pytaniach uzupełniających?
4. Analityka ruchu z poleceń i analityka produktowa
Czy użytkownicy rzeczywiście trafiają na platformę i wchodzą z nią w interakcję?
5. Wyniki biznesowe
Czy ścieżka prowadzi do wartościowych transakcji i wartości dla klienta?
Każda warstwa odpowiada na inne pytanie.
Razem dają znacznie pełniejszy obraz niż pojedynczy „wskaźnik widoczności w AI”.
Moje stanowisko
Monitorowanie botów AI powinno stać się standardowym elementem systemu obserwowalności dla SEO i GEO w dużych organizacjach.
Nie dlatego, że częstsze crawlowanie automatycznie oznacza większą widoczność.
Dostarcza nam ono wiedzy, której nie uzyskamy z samego monitorowania promptów:
jak systemy AI faktycznie korzystają z naszej infrastruktury i treści.
Połączmy to z widocznością w wyszukiwarkach, realistycznymi testami ścieżek w AI, ruchem, CVR, przychodami i lojalnością, a otrzymamy znacznie więcej niż dashboard crawlerów.
Będzie to kolejny sygnał pomagający zdecydować:
gdzie platforma jest silna, gdzie zawodzi i gdzie praca SEO/GEO może tworzyć realną wartość biznesową.
Ten kierunek interesuje mnie znacznie bardziej niż samo liczenie wzmianek w AI.
Źródła
- OpenAI: crawlery: dokumentacja opisuje różne role OAI-SearchBot, ChatGPT-User i GPTBot, w tym publikowane zakresy adresów IP.
- Anthropic: crawlery Claude: dokumentacja rozróżnia ClaudeBot, Claude-SearchBot i Claude-User według ich przeznaczenia.
- Cloudflare: analiza ruchu AI: dokumentacja przedstawia analizę według crawlera, operatora, hosta, ścieżki i kodu odpowiedzi, w tym dostęp programistyczny.
- Cloudflare: AI Crawl Control i WAF: dokumentacja wyjaśnia, jak reguły WAF mogą wpływać na dostęp crawlerów przed zastosowaniem innych mechanizmów kontroli crawlerów.
- Cloudflare: zweryfikowane boty: dokumentacja dostarcza kontekstu weryfikacji tożsamości bota zamiast polegania wyłącznie na ciągu User-Agent.
- Google: typowe crawlery i Google-Extended: dokumentacja opisuje role crawlerów Google i istotne ograniczenie: Google-Extended nie ma osobnego HTTP User-Agent.
Mój poprzedni artykuł: dlaczego monitoring AI powinien oceniać realistyczne ścieżki użytkowników zamiast pojedynczych promptów.
Wymieńmy się doświadczeniami
Jak to wygląda w Twojej praktyce?
Która z tych zmian już wpływa na pracę Twojego zespołu? Podziel się doświadczeniem na LinkedIn lub przeczytaj powiązaną notatkę na Substacku.