Artykuł · 25.10.2026
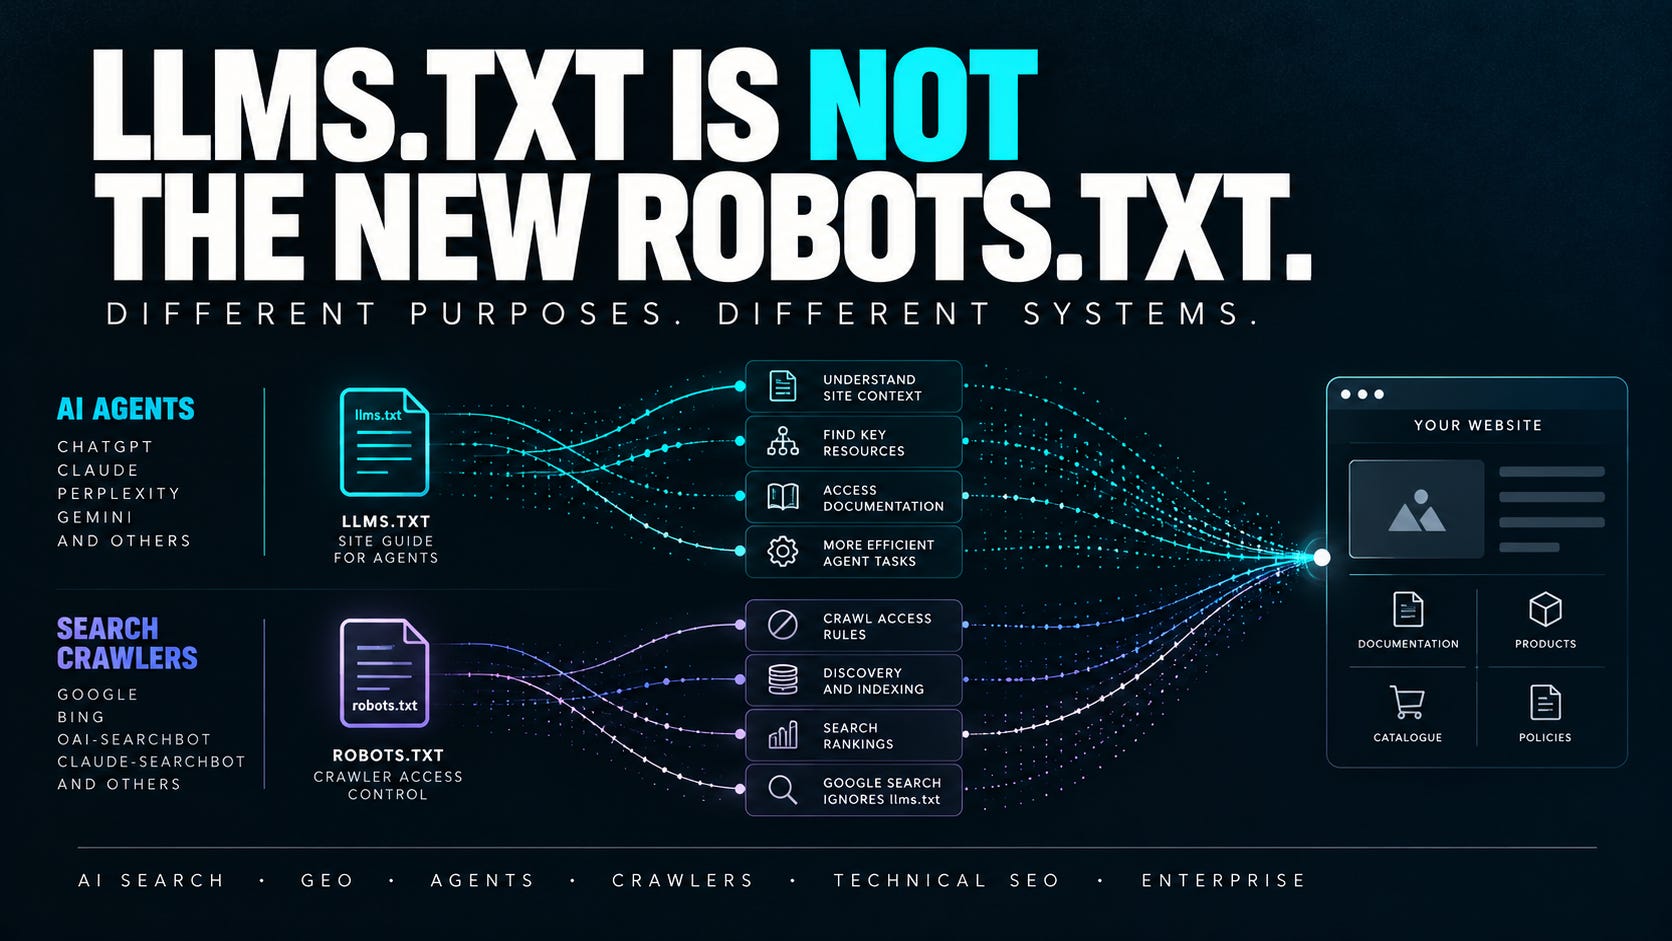
llms.txt to nie nowy robots.txt
Do czego służy llms.txt, jak dostawcy AI wykorzystują go w dokumentacji i dlaczego nawigacja agentów różni się od kontroli crawlerów i widoczności w AI Search.
W tym artykule
Co ten plik faktycznie robi, co powinien zawierać, jakie zastosowania wspierają dostawcy AI i dlaczego Google może sprawdzać go w Lighthouse, a jednocześnie ignorować w Search.
Wokół llms.txt rozwija się dość osobliwa sytuacja
- OpenAI publikuje taki plik.
- Anthropic publikuje taki plik.
- Perplexity publikuje taki plik.
- Google udostępnia endpoint llms.txt dla dokumentacji Gemini API i poleca go agentom programistycznym.
- Chrome Lighthouse sprawdza teraz jego działanie.
A mimo to Google Search mówi wprost:
nie potrzebujesz go.
Co ważniejsze, Google twierdzi, że Search z niego nie korzysta, również w funkcjach wyszukiwania opartych na generatywnej AI.
Na pierwszy rzut oka wygląda to na sprzeczność.
Ale nią nie jest.
Zamieszanie wynika z łączenia kilku zupełnie różnych warstw:
kontroli dostępu crawlerów, odkrywania zasobów, indeksowania, retrieval, nawigacji agentów i rankingu.
- llms.txt należy dziś przede wszystkim do warstwy nawigacji agentów i ułatwiania im pobierania informacji.
- Nie jest nowym robots.txt.
- Nie jest mapą witryny XML dla AI.
Obecnie nie ma też dowodów, że samo dodanie tego pliku poprawia widoczność w AI Search.
Czym jest llms.txt?
Propozycję pierwotnie opublikował Jeremy Howard we wrześniu 2024 roku. W sierpniu 2026 roku zaktualizowano ją do wersji 2.
Obecna specyfikacja opisuje llms.txt jako propozycję sposobu przedstawiania agentom AI przeglądu witryny w formie przyjaznej dla LLM.
Problem, który próbuje rozwiązać, jest zasadny.
Zwykłą stronę internetową projektuje się dla ludzi.
Może zawierać:
- nawigację
- reklamy
- JavaScript
- powtarzalne szablony
- interaktywny interfejs
- banery dotyczące plików cookie
- niezwiązane z tematem linki nawigacyjne
Agent, który próbuje zrozumieć witrynę, może najpierw potrzebować wyodrębnić z tego wszystkiego przydatne informacje.
llms.txt proponuje inną drogę:
udostępnij agentowi zwięzły dokument Markdown, który wyjaśnia, czym jest witryna i gdzie znajdują się ważne informacje.
Specyfikacja jest dostępna na llmstxt.org.
Kluczowe słowo to:
propozycja.
Dokumentacja samego projektu nadal określa go jako propozycję, a specyfikację jako nieformalny opis otwarty na uwagi społeczności.
To coś innego niż ugruntowany standard internetowy, taki jak Robots Exclusion Protocol.
Co powinien zawierać plik llms.txt?
Wersja 2 propozycji definiuje stosunkowo prostą strukturę Markdown.
Ściśle wymagany jest tylko nagłówek H1 z nazwą projektu lub witryny.
Plik może zawierać:
# Firma / Projekt

> Zwięzły opis wyjaśniający, czym zajmuje się witryna lub projekt.

Dodatkowy kontekst, który pomaga agentowi zinterpretować poniższe zasoby.

## Dokumentacja

- [Pierwsze kroki](...)
- [Dokumentacja API](...)
- [Architektura techniczna](...)

## Produkty

- [Katalog produktów](...)
- [Dokumentacja danych produktowych](...)

## Zasady

- [Zwroty](...)
- [Dostawa](...)
- [Regulamin](...)

## Optional

- [Zasób o niższym priorytecie](...)
Propozycja zaleca:
- H1 z nazwą projektu lub witryny
- blok cytatu ze zwięzłym podsumowaniem
- opcjonalny kontekst uzupełniający
- sekcje H2 grupujące ważne zasoby
- linki Markdown z opcjonalnymi opisami
- sekcję Optional na informacje o niższym priorytecie
Specyfikacja sugeruje też linkowanie do uproszczonych wersji ważnych stron w Markdown, jeśli są dostępne. Specyfikacja llms.txt
To wiele mówi o zamierzonym zastosowaniu.
llms.txt nie ma zawierać całej witryny.
Ma pomagać agentowi dotrzeć do właściwych informacji.
To nie jest mapa witryny
W przypadku dużej platformy enterprise unikałbym przekształcania llms.txt w kolejną mapę witryny XML.
Wyobraźmy sobie marketplace obejmujący:
- 100 milionów produktów
- tysiące kategorii
- miliony sprzedawców
- wiele krajów
- warianty
- oferty
- adresy URL nawigacji fasetowej
Umieszczenie wszystkich tych adresów w llms.txt mijałoby się z celem.
Proponowany plik jest starannie dobraną mapą zasobów.
Dla platformy e-commerce klasy enterprise rozważyłbym udostępnienie takich informacji jak:
- Kontekst platformy: czym zajmuje się marketplace lub platforma?
- Główne obszary działalności: które rynki, kategorie lub usługi są istotne?
- Ważna dokumentacja: specyfikacje danych produktowych, dokumentacja dla sprzedawców, API, feedy, centra pomocy.
- Zasady: zwroty, dostawa, gwarancje, wymagania wobec sprzedawców i inne wiarygodne informacje.
- Ważne punkty wejścia do informacji o encjach: główne strony kategorii, katalogi sprzedawców lub zasoby wspierające odkrywanie produktów, jeśli ma to zastosowanie.
- Zasoby czytelne maszynowo: feedy, API, dokumentacja Markdown lub ustrukturyzowane pliki referencyjne, jeśli rzeczywiście pomagają agentowi.
Celem nie jest:
wymienić wszystko.
Celem jest:
dać agentowi najkrótszą wiarygodną drogę do autorytatywnych informacji.
llms.txt to nie robots.txt
To prawdopodobnie najważniejsze rozróżnienie.
robots.txt przekazuje preferencje dotyczące dostępu crawlerów.
Na przykład:
User-agent: OAI-SearchBot
Disallow: /
lub:
User-agent: ClaudeBot
Disallow: /
Te dyrektywy informują, czy określone systemy automatyczne powinny crawlować wskazane zasoby.
llms.txt tego nie robi.
- Nie jest mechanizmem kontroli dostępu.
- Nie udostępnia ustandaryzowanego systemu Allow / Disallow.
- Nie zapobiega trenowaniu modeli.
- Nie zapobiega indeksowaniu.
- Nie decyduje o tym, czy dany URL może pojawić się w odpowiedzi AI.
Sama obecna propozycja llms.txt opisuje te dwa pliki jako rozwiązania służące różnym celom.
- W przypadku OpenAI udokumentowanym mechanizmem kontroli OAI-SearchBot i GPTBot pozostaje robots.txt. Dokumentacja crawlerów OpenAI
- Anthropic również dokumentuje sterowanie dostępem ClaudeBot, Claude-User i Claude-SearchBot za pomocą robots.txt. Dokumentacja crawlerów Anthropic
- Perplexity także wskazuje robots.txt jako mechanizm regulujący crawling i indeksowanie przez PerplexityBot. Dokumentacja crawlera Perplexity
Dlatego nie nazywałbym llms.txt odpowiednikiem robots.txt dla AI.
Te pliki działają na różnych warstwach.
Czy llms.txt jest oficjalnym standardem dostawców AI?
Obecnie nie.
Potrzebne jest tu jednak doprecyzowanie, ponieważ kilka firm AI publikuje już pliki llms.txt.
OpenAI udostępnia taki plik dla swojej dokumentacji deweloperskiej:
Anthropic również:
Podobnie Perplexity:
Dokumentacja Google Gemini API także udostępnia indeks dokumentacji llms.txt i wprost informuje agentów programistycznych, że mogą go używać do pobierania dokumentacji w uproszczonej postaci. Dokumentacja Gemini dla agentów programistycznych
To pokazuje przyjęcie tego rozwiązania.
Ale przyjęcie rozwiązania nie jest tym samym co obsługa przez crawlery przeszukujące publiczny internet.
Publikowanie pliku llms.txt dla własnej dokumentacji technicznej mówi nam:
uważamy to za przydatny interfejs dla agentów korzystających z naszej dokumentacji.
Nie mówi nam automatycznie:
nasz crawler wyszukiwarki sprawdza llms.txt w każdej witrynie i wykorzystuje go do odkrywania zasobów, indeksowania lub rankingu.
To bardzo różne twierdzenia.
Dlaczego więc Google Lighthouse sprawdza llms.txt?
To prawdopodobnie najciekawsza część tej historii.
Chrome Lighthouse obejmuje teraz kontrolę llms.txt.
To zrozumiałe, że wzbudziło to duże zainteresowanie.
Warto jednak zobaczyć, gdzie znajduje się ten audyt. Jest częścią audytów Agentic Browsing, a nie kategorii audytów SEO.
Dokumentacja Google Lighthouse nazywa llms.txt „rozwijającą się konwencją”, która może dostarczać LLM i agentom podsumowanie czytelne maszynowo. Co ważniejsze, sposób działania audytu pokazuje, jak Google ocenia znaczenie tego pliku. Jeśli Lighthouse wysyła żądanie do /llms.txt i otrzymuje błąd serwera, może zgłosić problem.
Jeśli jednak plik po prostu nie istnieje i zwraca standardowy kod 404, audyt otrzymuje status:
Not Applicable, czyli nie dotyczy.
Google wyraźnie wyjaśnia, że wynika to z opcjonalnego charakteru pliku. Dokumentacja Lighthouse dotycząca llms.txt
To zupełnie inny sygnał niż:
każda witryna potrzebuje tego pliku.
W praktyce Lighthouse mówi:
jeśli decydujesz się udostępnić zasób przeznaczony dla agentów, zadbaj o jego poprawne działanie.
Tymczasem Google Search mówi: ignorujemy ten plik
Google Search Central jest znacznie bardziej jednoznaczne.
Obecny przewodnik dotyczący generatywnej AI w Search wymienia llms.txt wśród rzeczy, które właściciele witryn mogą pominąć w kontekście Google Search.
Google informuje, że witryny nie potrzebują nowych plików AI czytelnych maszynowo ani plików Markdown, aby pojawiać się w Google Search, również w jego funkcjach generatywnej AI.
Idzie jeszcze dalej:
- Google Search z nich nie korzysta.
- Utworzenie llms.txt dla innej usługi ani nie pomoże, ani nie zaszkodzi widoczności w Google Search, ponieważ Google Search ignoruje ten plik. Przewodnik Google po optymalizacji dla AI Search
- Google oficjalnie dodało to wyjaśnienie do dokumentacji Search 15 czerwca 2026 roku. Aktualizacje dokumentacji Google Search
Mamy więc następującą sytuację:
- Chrome / agentic browsing: llms.txt może być przydatny.
- Narzędzia deweloperskie Gemini: llms.txt może pomagać agentom programistycznym poruszać się po dokumentacji.
- Google Search: llms.txt jest ignorowany.
- Te stwierdzenia są w pełni zgodne.
Odkrywanie zasobów to nie to samo co funkcjonalność agenta
To szerszy wniosek techniczny.
System AI może korzystać z zasobu, a zasób ten nie musi przez to stawać się czynnikiem rankingowym.
Agent może być na przykład zaprogramowany tak, by przed rozpoczęciem przeglądania witryny z dokumentacją pobrać:
https://example.com/llms.txt
Mogłoby to sprawić, że wykonanie zadania przez agenta będzie:
- szybsze
- tańsze
- bardziej deterministyczne
- mniej wymagające pod względem liczby tokenów
- łatwiejsze dzięki prostszej nawigacji
Żadna z tych korzyści nie oznacza jednak, że:
- Google lepiej indeksuje Twoją witrynę
- ChatGPT częściej Cię cytuje
- Claude daje Ci wyższą pozycję
- Perplexity Cię poleca
- rośnie ruch odsyłający z systemów AI
Musimy rozdzielać poszczególne etapy.
- Użyteczność dla agenta ≠ crawling
- Crawling ≠ indeksowanie
- Indeksowanie ≠ retrieval
- Retrieval ≠ cytowanie
- Cytowanie ≠ ruch odsyłający
- Ruch odsyłający ≠ przychód
Właśnie w tym miejscu dyskusje o GEO często stają się zbyt uproszczone.
Czy zatem warto wdrożyć llms.txt?
Moja odpowiedź brzmi:
czasami.
W przypadku platformy z rozbudowaną dokumentacją uważam, że bilans kosztów i korzyści może już przemawiać za wdrożeniem.
Przykłady obejmują:
- platformy deweloperskie
- API
- dokumentację SaaS
- techniczne bazy wiedzy
- złożoną dokumentację produktową
- witryny celowo projektowane do interakcji z agentami
Zwłaszcza jeśli plik można generować automatycznie.
To, że OpenAI, Anthropic i Perplexity wykorzystują ten wzorzec we własnej dokumentacji, jest istotną przesłanką przemawiającą za wartością tego zastosowania.
Traktowałbym go jednak jako interfejs dla agentów, a nie skrót do wyników w SEO.
W przypadku dużego marketplace’u rachunek wygląda inaczej.
Wdrożyłbym go tylko wtedy, gdy potrafimy odpowiedzieć na trzy pytania:
1. Jaki problem to rozwiązuje?
Które agenty lub narzędzia wewnętrzne będą z niego korzystać?
2. Czy potrafimy go rzetelnie utrzymywać?
Czy można go generować na podstawie istniejących systemów zarządzania treścią, katalogiem lub dokumentacją?
3. Czy tworzymy kolejne źródło prawdy?
Jeśli tak, zachowałbym ostrożność.
Ręcznie utrzymywany llms.txt, który podaje inne informacje niż katalog, zasady i witryna, tworzy problemy z jakością danych zamiast je rozwiązywać.
Jak wdrożyłbym to w organizacji enterprise
Generowałbym plik na podstawie istniejących systemów będących autorytatywnymi źródłami danych.
Na przykład:
- CMS dokumentacji → llms.txt
- System informacji produktowej → dokumentacja danych produktowych
- CMS zasad i regulaminów → linki do obowiązujących zasad
- Katalog API → dokumentacja API czytelna maszynowo
- Platforma dla sprzedawców → specyfikacje onboardingu i feedów
Sam plik powinien pozostać warstwą nawigacyjną:
- Nie kolejną bazą danych.
- Nie kolejną mapą witryny.
- Nie kolejnym miejscem, w którym zespoły marketingowe ręcznie utrzymują informacje o firmie.
- A już na pewno nie miejscem na dopisywanie twierdzeń tylko dlatego, że ktoś liczy, iż LLM je powtórzy.
Co potraktowałbym priorytetowo przed llms.txt
Jeśli organizacja pyta mnie:
czy powinniśmy wdrożyć llms.txt dla GEO?
najpierw sprawdziłbym, czy mamy już:
- HTML dostępny dla crawlerów
- poprawną konfigurację robots.txt
- prawidłowe kody odpowiedzi HTTP
- stabilne kanoniczne adresy URL
- użyteczne linkowanie wewnętrzne
- poprawne dane ustrukturyzowane
- dobrej jakości feedy produktowe
- aktualną dokumentację
- dostępne API tam, gdzie mają zastosowanie
- spójne dane o encjach i katalogu
- monitoring zachowania crawlerów AI
Te fundamenty już dziś wpływają na rzeczywiste systemy odkrywania i pobierania informacji.
llms.txt jest następny w kolejności.
Nie pierwszy.
Mój wniosek
llms.txt to jeden z ciekawszych rozwijających się wzorców architektury internetowej przyjaznej agentom.
Jednocześnie przypisuje mu się zbyt wiele.
Obecne dowody uzasadniają taki opis:
Lekka, rozwijająca się konwencja udostępniania agentom AI starannie dobranej, czytelnej maszynowo mapy ważnych zasobów witryny.
Nie uzasadniają natomiast określenia:
Obowiązkowy plik AI SEO.
I zdecydowanie nie uzasadniają określenia:
Nowy czynnik rankingowy dla ChatGPT, Claude, Perplexity lub Google AI Search.
Najmocniejszym obecnym zastosowaniem wydaje się dokumentacja i nawigacja agentów.
To ma wartość.
Powinniśmy jednak nazywać ten plik zgodnie z jego rolą. llms.txt to warstwa ułatwiająca agentom korzystanie z witryny.
- Nie standard kontroli crawlerów.
- Nie standard rankingu AI.
- I nie nowy robots.txt.
Źródła
- Specyfikacja llms.txt: https://llmstxt.org/
- Przewodnik Google po optymalizacji dla AI Search: https://developers.google.com/search/docs/fundamentals/ai-optimization-guide, Google Search ignoruje llms.txt.
- Lighthouse: llms.txt: https://developer.chrome.com/docs/lighthouse/agentic-browsing/llms-txt, opcjonalny audyt Agentic Browsing; 404 = nie dotyczy.
- Crawlery OpenAI: https://developers.openai.com/api/docs/bots
- llms.txt OpenAI: https://developers.openai.com/llms.txt
- Crawlery Anthropic: https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
- llms.txt Anthropic: https://platform.claude.com/llms.txt
- llms.txt Perplexity: https://docs.perplexity.ai/llms.txt
- Dokumentacja Gemini dla agentów programistycznych: https://ai.google.dev/gemini-api/docs/coding-agents
Wymieńmy się doświadczeniami
Jak to wygląda w Twojej praktyce?
Która z tych zmian już wpływa na pracę Twojego zespołu? Podziel się doświadczeniem na LinkedIn lub przeczytaj powiązaną notatkę na Substacku.