Artykuł · 26.10.2026
SEO/GEO potrzebuje warstwy obsługi agentów
Dlaczego gotowość e-commerce na agentów wymaga semantycznego HTML, programowo dostępnych informacji o stanie, spójnych danych produktowych i testów ukończenia zadań we współpracy z Product i Engineering.
W tym artykule
Sama możliwość odnalezienia witryny już nie wystarcza. Witryny coraz częściej muszą być zrozumiałe dla agentów AI, umożliwiać im wykonywanie działań i pozwalać na testowanie tych interakcji.
Przez lata techniczne SEO koncentrowało się na dość jasnej sekwencji:
odkrywanie → crawling → renderowanie → indeksowanie → ranking
GEO i AI Search dodały kolejne warstwy:
retrieval → ugruntowanie odpowiedzi w źródłach → cytowanie → kierowanie użytkownika do witryny
Agenci przeglądarkowi wprowadzają jednak jeszcze jedną.
Działanie.
Agent nie musi kończyć pracy na znalezieniu witryny czy wyodrębnieniu z niej informacji.
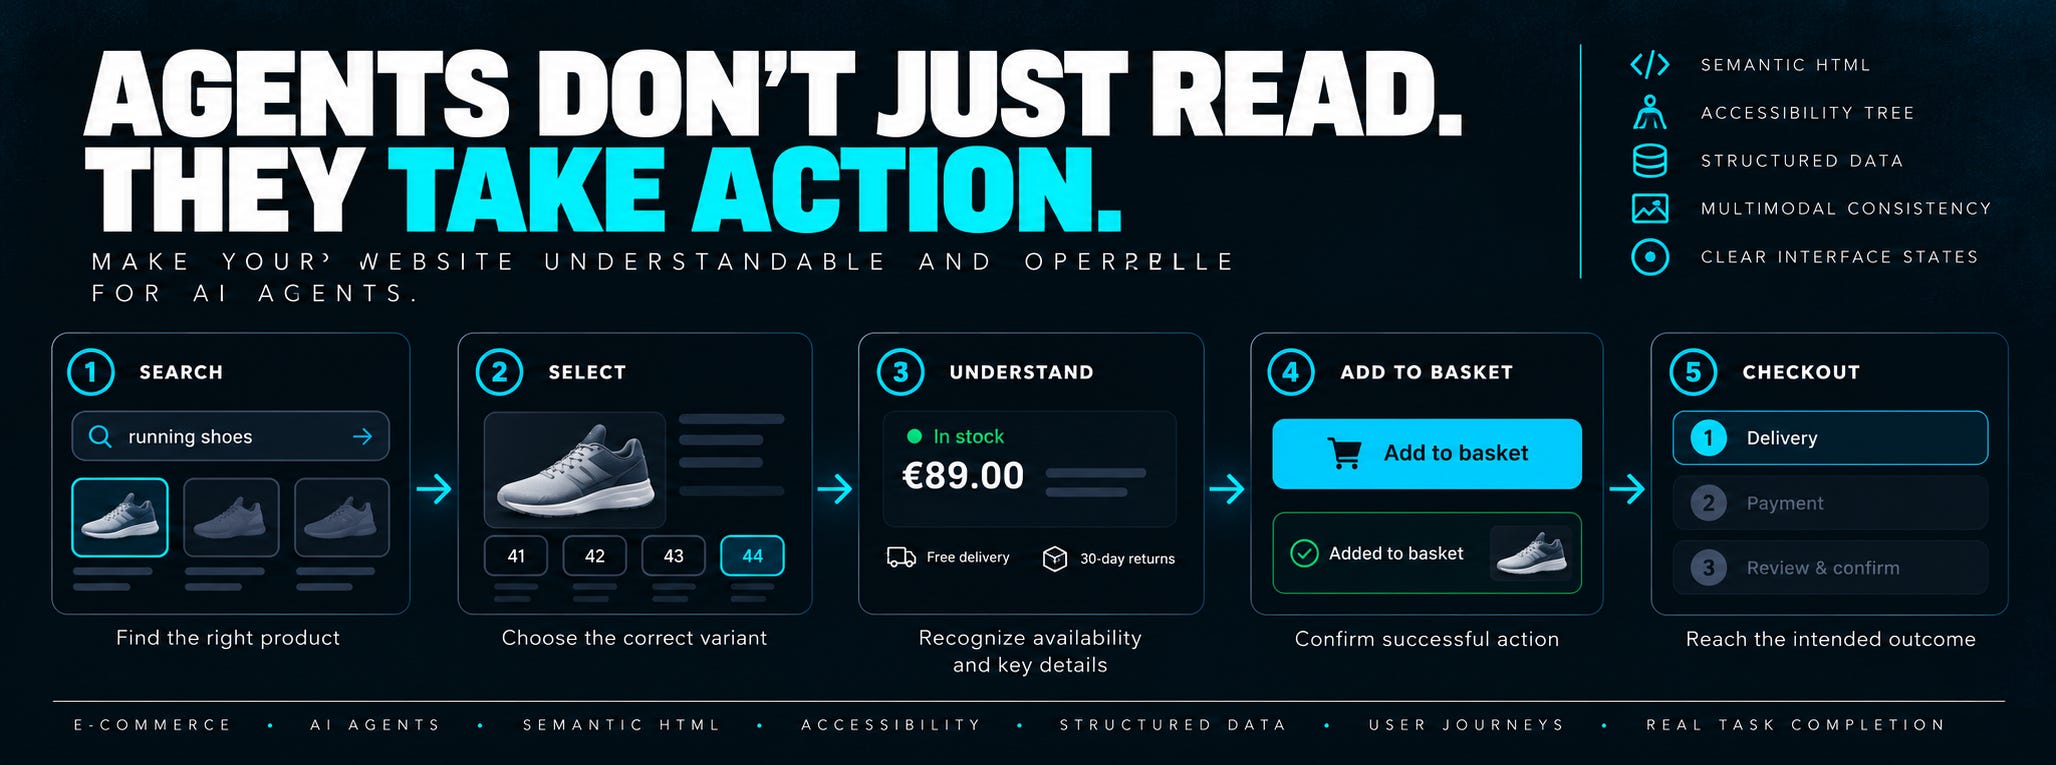
Może potrzebować przeszukać katalog, porównać produkty, wybrać ofertę i wariant, dodać coś do koszyka, wypełnić formularz lub przejść w kierunku finalizacji zamówienia.
To zasadniczo inne wymaganie techniczne.
Pytanie nie brzmi już tylko:
Czy zautomatyzowany system potrafi zrozumieć tę stronę?
Coraz częściej brzmi:
Czy zautomatyzowany system potrafi skutecznie korzystać z tej witryny?
Uważam, że w e-commerce na poziomie enterprise to rozróżnienie zasługuje na znacznie więcej uwagi.
Crawlery i agenci mają różne zadania
Crawler przede wszystkim odkrywa i pobiera zasoby.
Agent działa z myślą o osiągnięciu celu.
Wytyczne Google Search opisują agentów AI jako systemy, które mogą wykonywać zadania w imieniu użytkowników, na przykład porównywać specyfikacje produktów czy rezerwować usługi. Według tych wytycznych agenci przeglądarkowi mogą zbierać informacje z witryn, analizując ich wygląd po wyrenderowaniu, DOM i drzewo dostępności.
Dokumentacja computer use OpenAI przedstawia praktyczny przykład tej samej zmiany.
Agenci OpenAI mogą poruszać się po witrynach, analizować interfejsy przeglądarkowe i wchodzić z nimi w interakcje, aby realizować zadania.
Pozwala to wprowadzić przydatne rozróżnienie.
Crawler może potrzebować ustalić:
- czego dotyczy strona;
- jakie adresy URL istnieją;
- jaki produkt jest prezentowany;
- jaka cena jest opublikowana.
Agent może dodatkowo potrzebować ustalić:
- który przycisk dodaje produkt do koszyka;
- czy wybrano rozmiar M;
- czy ten rozmiar jest dostępny;
- czy okno modalne blokuje interfejs;
- czy aktualizacja koszyka się powiodła;
- czy finalizacja zamówienia wymaga uwierzytelnienia;
- czy wystąpił błąd;
- czy można bezpiecznie kontynuować.
To znacznie wyższe wymagania.
Agenci widzą więcej niż jedną reprezentację witryny
Jednym z najbardziej użytecznych elementów niedawnych wytycznych Google dla agentów jest opis tego, jak agenci przeglądarkowi postrzegają stronę.
Poradnik Google na web.dev wyróżnia trzy główne reprezentacje:
zrzuty ekranu, HTML/DOM i drzewo dostępności.
Każda przekazuje agentowi inne informacje.
Widok po wyrenderowaniu
Zrzut ekranu pokazuje układ, bliskość elementów, hierarchię, kolor i stan wizualny.
Agent może na podstawie obrazu uznać, że duży przycisk pod ceną prawdopodobnie odnosi się do produktu znajdującego się powyżej.
Interpretacja wizualna wiąże się jednak z większym kosztem i nadal może być niejednoznaczna.
DOM i semantyczny HTML
DOM dostarcza strukturę i relacje.
Natywny <button> jasno komunikuje działanie.
Natywny <a href> komunikuje nawigację.
Element <label> powiązany z polem wyjaśnia, jakiej wartości to pole oczekuje.
Zwykły <div> z obsługą kliknięcia w JavaScript może wyglądać dla człowieka dokładnie jak przycisk, a jednocześnie przekazywać maszynie znacznie mniej informacji o swoim przeznaczeniu.
Drzewo dostępności
Drzewo dostępności udostępnia uproszczony obraz interfejsu, obejmujący między innymi:
- nazwy;
- role;
- wartości;
- stany;
- relacje.
Wytyczne Google dotyczące witryn przyjaznych agentom opisują to drzewo jako szczególnie użyteczną reprezentację czytelną dla maszyn. Powstało ono przede wszystkim z myślą o dostępności. To nadal jego najważniejszy cel.
Dobrze zaprojektowana architektura dostępności przynosi jednak dodatkową korzyść: agenci otrzymują czytelniejszą reprezentację interfejsu.
Wytyczne W3C wyjaśniają, dlaczego natywne elementy sterujące są tu wartościowe. Standardowe kontrolki formularzy HTML i linki udostępniają swoją rolę, nazwę, stan i wartość przez interfejsy API dostępności przeglądarki oraz zapewniają oczekiwaną obsługę klawiatury.
To nie jest trik SEO. To dobra praktyka inżynierii webowej, która staje się coraz przydatniejsza w środowisku agentów.
Semantyczny HTML staje się infrastrukturą operacyjną
W SEO semantyczny HTML tradycyjnie pomagał porządkować strukturę.
Agentom może także ułatwiać wykonywanie działań.
Rozważmy dwie implementacje.
Pierwsza wygląda tak:
<div class="buy" onclick="addToCart()">Buy now</div>
Druga tak:
<button type="button">
  Add to basket
</button>
Człowiek może dostrzec niewielką różnicę.
Dla agenta druga wersja może stanowić znacznie bardziej jednoznaczną deklarację zachowania.
To samo dotyczy całej ścieżki w e-commerce.
- Link powinien służyć do nawigacji.
- Przycisk powinien wykonywać działanie.
- Kontrolka formularza powinna udostępniać swoją etykietę.
- Wybrana opcja powinna udostępniać stan zaznaczenia.
- Niedostępna opcja powinna faktycznie być wyłączona.
Brzmi to jak podstawy.
W skali enterprise ich wdrożenie często wcale nie jest proste.
Systemy projektowe, abstrakcje frontendowe i niestandardowe komponenty JavaScript potrafią odtwarzać podstawowe zachowania przeglądarki tak, że wyglądają poprawnie, ale udostępniają niepełną semantykę.
Agenci uwidaczniają te słabości.
Drzewo dostępności musi odzwierciedlać właściwy stan
Rozpoznanie kontrolki to dopiero połowa problemu.
Agenci muszą zrozumieć, co stało się po jej użyciu.
Wyobraźmy sobie agenta próbującego kupić buty.
- Wybiera rozmiar 44.
- W interfejsie zmienia się obramowanie tego rozmiaru.
- Nic jednak nie wskazuje programowo, że rozmiar 44 jest teraz wybrany.
- Agent może kliknąć go ponownie.
- Albo wybrać inny rozmiar.
- Albo uznać, że interakcja się nie powiodła.
Ten sam problem dotyczy:
- rozwiniętych filtrów;
- zaznaczonych pól wyboru;
- wybranych wariantów produktu;
- wyłączonych przycisków;
- niedostępnych zapasów;
- błędów walidacji;
- okien modalnych;
- stanów ładowania;
- udanego dodania do koszyka;
- liczby sztuk w koszyku.
Stan interfejsu nie powinien istnieć wyłącznie wizualnie.
Jeśli system oczekuje, że użytkownicy lub agenci będą podejmować decyzje na podstawie tego stanu, powinien on być dostępny programowo.
To naturalny punkt styku inżynierii dostępności i przygotowania witryny do obsługi agentów.
Dane strukturalne nadal mają znaczenie, ale z innego powodu
Dane strukturalne to kolejna reprezentacja produktu.
W e-commerce mogą przekazywać jednoznaczne informacje, takie jak:
- Product;
- Offer;
- cena;
- waluta;
- dostępność;
- sprzedawca;
- ocena;
- relacje między wariantami.
Wytyczne Google Search wyjaśniają, że Google wykorzystuje dane strukturalne do rozumienia treści strony i obsługi funkcji Search, do których dana treść się kwalifikuje.
Nie należy jednak mylić danych strukturalnych z warstwą interakcji.
Schema może powiedzieć maszynie:
Ta oferta kosztuje 99 EUR, a produkt jest dostępny.
Nie musi jednak mówić agentowi przeglądarkowemu:
To jest kontrolka, której trzeba użyć, aby wybrać rozmiar 44 i dodać go do tego koszyka.
Obie warstwy mają znaczenie.
Rozwiązują różne problemy.
To rozróżnienie między rozumieniem encji a obsługą interfejsu.
Spójność multimodalna staje się kluczowa
Współcześni agenci mogą łączyć wiele reprezentacji.
Dlatego sprzeczności stają się szczególnie niebezpieczne.
Wyobraźmy sobie stronę produktu, na której:
- Widoczny tekst: 89 EUR.
- Dane strukturalne produktu: 99 EUR.
- Feed produktowy: 94 EUR.
- Zdjęcie: czerwony produkt.
- Wybrany wariant: niebieski produkt.
- Tekst alternatywny: czarny produkt.
- Dostępność w interfejsie: brak w magazynie.
- JSON-LD: InStock.
Której wersji agent powinien zaufać?
To nie jest w swojej istocie problem AI.
To problem zarządzania danymi.
Najlepsze wdrożenie powinno traktować widoczną treść, dane strukturalne, metadane mediów, informacje o dostępności cyfrowej i feedy jako różne reprezentacje tej samej encji.
Nie muszą powtarzać identycznych sformułowań.
Muszą jednak opisywać ten sam produkt, wariant, ofertę i stan.
Dokumentacja Google Search zaleca dalsze używanie odpowiednich obrazów i filmów w kontekście funkcji generatywnej AI oraz utrzymywanie standardowych podstaw technicznych zamiast wymyślania zamienników specyficznych dla AI.
Warstwa agentowa zwiększa wartość tej spójności.
Obrazy i multimedia nie mogą przekazywać informacji wyłącznie wizualnie
Interfejs e-commerce często komunikuje informacje za pomocą elementów wizualnych.
- Próbki kolorów.
- Zdjęcia produktów.
- Tabele rozmiarów.
- Tabele porównawcze.
- Oznaczenia.
- Filmy demonstracyjne.
- Ikony.
Agenci mogą interpretować część z nich za pomocą analizy obrazu.
Poleganie wyłącznie na niej tworzy jednak niepotrzebną niejednoznaczność.
Ważne informacje powinny mieć odpowiedni tekst, semantykę lub metadane.
W zależności od treści oznacza to:
- użyteczny tekst alternatywny;
- podpisy;
- kontekst produktu w otaczającej treści;
- znaczące nazwy kontrolek;
- adresy URL obrazów dostępne dla crawlerów;
- ustrukturyzowane powiązania mediów;
- transkrypcje odpowiednich treści wideo lub audio.
Wytyczne Google na web.dev zalecają zapewnienie równoważnych informacji, gdy obrazy lub inne reprezentacje wizualne są niedostępne.
Ponownie: na pierwszym miejscu jest dostępność.
Łatwiejsza obsługa przez agentów to dodatkowa korzyść.
Interfejs musi komunikować rezultaty
W tym miejscu, moim zdaniem, zespoły e-commerce powinny wyjść poza standardowe QA w SEO.
Załóżmy, że agent klika:
Dodaj do koszyka
Co dzieje się dalej?
Możliwości jest wiele:
- przycisk zostaje wyłączony;
- pojawia się wskaźnik ładowania;
- krótkie powiadomienie potwierdza sukces;
- zmienia się licznik koszyka;
- otwiera się boczny panel;
- następuje przekierowanie;
- wywołanie API kończy się błędem;
- wybrany wariant przestaje być dostępny;
- pojawia się okno uwierzytelnienia.
Ludzie łączą informacje wizualne, znajomość konwencji interfejsów i kontekst, aby zrozumieć sytuację.
Agenci potrzebują równie jasnych sygnałów.
Solidny interfejs powinien komunikować:
- Działanie: Co mogę zrobić?
- Stan: Co jest aktualnie wybrane lub dostępne?
- Zmianę stanu: Co dzieje się teraz?
- Wynik: Czy się udało?
- Niepowodzenie: Dlaczego się nie udało?
- Następne działanie: Co mogę teraz zrobić?
To moment, w którym gotowość na agentów przestaje być problemem treści, a staje się zagadnieniem produktowym i inżynieryjnym.
Stabilność układu też ma znaczenie
Artykuł Chrome o zestawie narzędzi dla witryn gotowych na agentów opisuje kategorię Agentic Browsing w Lighthouse, która sprawdza stabilność wizualną obok dostępności i integracji z WebMCP.
Powód jest praktyczny.
Jeśli agent rozpozna przycisk Dodaj do koszyka, a układ przesunie się przed kliknięciem, może kliknąć coś innego.
Chrome wprost wskazuje stabilność układu jako czynnik pomagający zapobiegać błędnym kliknięciom agentów.
Zespoły SEO znają już CLS z Core Web Vitals.
Korzystanie z witryn przez agentów nadaje stabilności układu kolejne znaczenie operacyjne.
WebMCP może stać się kolejną warstwą
Pojawia się też próba wyjścia poza pośrednie interpretowanie interfejsów przez agentów.
Projekt WebMCP rozwijany przez Chrome proponuje udostępnianie agentom ustrukturyzowanych narzędzi bezpośrednio przez witryny.
Zamiast zmuszać agenta do wnioskowania:
To prawdopodobnie przycisk przejścia do finalizacji zamówienia.
Witryna mogłaby udostępnić jawne narzędzie, takie jak:
checkout
lub:
filter_results
wraz z ustrukturyzowanymi danymi wejściowymi, wyjściowymi i bieżącym stanem.
Chrome argumentuje, że może to zwiększyć niezawodność działań agentów dzięki ograniczeniu liczby niejednoznacznych etapów interpretacji interfejsu.
Z czasem może to mieć duże znaczenie dla e-commerce.
Agent mógłby otrzymać jawne operacje służące do:
- wyszukiwania produktów;
- stosowania filtrów;
- wybierania dat;
- wybierania wariantów;
- dodawania produktów;
- rozpoczynania finalizacji zamówienia.
Zachowałbym jednak ostrożność w ocenie dojrzałości tej technologii.
WebMCP jest obecnie propozycją standardu.
Należy traktować go jako stopniowe rozszerzenie istniejącej funkcjonalności i warstwę eksperymentalną.
Nie odkładałbym naprawy semantycznego HTML, dostępności czy stanów interfejsu w oczekiwaniu na nowy protokół.
Najpierw podstawy.
Prawdziwym sprawdzianem jest ukończenie zadania
To prowadzi do obszaru, który moim zdaniem powinien najbardziej interesować zespoły SEO/GEO. Gotowość na agentów wymaga testowania. Sama walidacja nie wystarcza.
Automatyczne walidatory mogą powiedzieć, czy:
- dane strukturalne mają poprawną składnię;
- kontrolki mają nazwy;
- strony zawierają semantyczny HTML;
- występują naruszenia reguł dostępności;
- pojawiają się przesunięcia układu.
To użyteczne informacje.
Nie odpowiadają jednak na ostateczne pytanie:
Czy agent potrafi ukończyć zadanie?
Chrome już zmierza w tym kierunku.
Kategoria Agentic Browsing w Lighthouse zapewnia deterministyczne kontrole dotyczące dostępności, stabilności i rozwijających się interfejsów dla agentów.
Artykuł Chrome o tym zestawie narzędzi opisuje także wykorzystanie Chrome DevTools for Agents do symulowania rzeczywistych interakcji agentów, odtwarzania błędów i weryfikowania ścieżek.
Wskazuje to przydatny model testowania w organizacjach enterprise.
Model testowania gotowości na agentów
Testowałbym co najmniej cztery warstwy.
Warstwa 1: reprezentacja
Sprawdź:
- surowy HTML;
- wyrenderowany DOM;
- drzewo dostępności;
- dane strukturalne;
- widok strony po wyrenderowaniu;
- metadane mediów;
- feedy produktowe.
Zapytaj:
Czy opisują tę samą encję i ten sam stan?
Warstwa 2: możliwość wykonywania działań
Sprawdź, czy ważne kontrolki udostępniają:
- jasne nazwy;
- poprawne role;
- oczekiwane typy pól wejściowych;
- stan zaznaczenia;
- stan wyłączenia;
- komunikaty walidacji;
- stan ładowania;
- informację o sukcesie lub niepowodzeniu.
Warstwa 3: realizacja zadania
Wyznacz agentom przeglądarkowym rzeczywiste cele.
Na przykład:
Znajdź najtańsze dostępne czarne buty do biegania w rozmiarze 44.
Porównaj te dwa produkty i wybierz ten z lepszą gwarancją.
Znajdź pralkę poniżej 500 EUR z dostawą w tym tygodniu.
Dodaj wybrany produkt do koszyka.
Przejdź do finalizacji zamówienia z właściwym produktem, wariantem, liczbą sztuk i ceną.
W przypadku działań o istotnych konsekwencjach, takich jak ostateczny zakup, testowałbym, czy agent niezawodnie dociera do punktu wymagającego potwierdzenia przez człowieka, zamiast zakładać, że każda transakcja powinna przebiegać autonomicznie.
Wytyczne OpenAI dotyczące computer use zalecają ostrożne podejście do potwierdzania działań przeglądarkowych o istotnych konsekwencjach, a dokumentacja WebMCP w Chrome również opisuje obsługę interakcji z człowiekiem przy wrażliwych działaniach, takich jak zakup.
Warstwa 4: weryfikacja wyniku
Nie traktuj kliknięcia jako sukcesu.
Zweryfikuj:
- właściwe SKU;
- właściwy wariant;
- właściwą cenę;
- właściwą liczbę sztuk;
- oczekiwany stan koszyka;
- oczekiwany stan nawigacji;
- wymagane potwierdzenie użytkownika;
- brak błędów niewidocznych dla użytkownika.
Agent nie powinien jedynie wykonać działania.
Powinien osiągnąć właściwy wynik biznesowy.
Klasyfikacja niepowodzeń ma znaczenie
W skali enterprise klasyfikowałbym niepowodzenia agentów.
Na przykład:
- Niepowodzenie odkrywania: Agent nie potrafi znaleźć odpowiedniego produktu lub strony.
- Niepowodzenie rozumienia: Agent znajduje zasób, ale błędnie interpretuje encję, cenę lub wariant.
- Niepowodzenie działania: Agent rozumie zadanie, ale nie potrafi obsłużyć kontrolki.
- Niepowodzenie rozpoznania stanu: Agent wykonuje działanie, ale nie potrafi ustalić, czy się powiodło.
- Problem ze spójnością: Różne reprezentacje strony przekazują sprzeczne informacje.
- Niepowodzenie całej ścieżki: Poszczególne komponenty działają, ale pełny proces się załamuje.
- Problem z bezpieczeństwem lub potwierdzeniem: Agent nie potrafi rozpoznać, kiedy potrzebna jest zgoda człowieka.
Dzięki temu gotowość na agentów przestaje być nieprecyzyjną inicjatywą AI, a staje się czymś, co zespoły inżynieryjne mogą mierzyć i poprawiać.
Co powinniśmy mierzyć?
W tym miejscu rozszerzyłbym wspólne źródło prawdy dla SEO/GEO, czyli Single Source of Truth.
Już monitorujemy między innymi:
- żądania crawlerów;
- indeksowanie;
- pozycje w wynikach;
- cytowania w AI;
- ruch odsyłający z AI.
W przypadku ścieżek obsługiwanych przez agentów z czasem dodałbym:
- Odsetek zadań ukończonych przez agenta: Jaki procent zdefiniowanych zadań kończy się sukcesem?
- Odsetek niepowodzeń na poszczególnych etapach: W którym miejscu ścieżka się załamuje?
- Trafność rozpoznawania stanu: Czy agent poprawnie rozpoznaje dostępność, wybór i rezultaty?
- Odsetek skutecznego powrotu do realizacji zadania: Czy agent potrafi kontynuować po błędach walidacji, zmianach dostępności lub pojawieniu się wymogu uwierzytelnienia?
- Możliwość doprowadzenia ścieżki do etapu komercyjnego: Ile ścieżek agentów skutecznie dociera do koszyka lub finalizacji zamówienia?
To daje znacznie więcej podstaw do działania niż sama informacja, że bot AI odwiedził stronę produktu.
To zmienia model operacyjny SEO/GEO
Nie uważam, że SEO powinno nagle przejąć odpowiedzialność za dostępność frontendu czy architekturę finalizacji zamówienia.
To byłby niewłaściwy wniosek.
Zespoły SEO/GEO mają jednak coraz lepszą pozycję, by rozpoznawać miejsca, w których odkrywanie zasobów przez maszyny styka się z doświadczeniem korzystania z produktu.
Wymaga to współpracy między zespołami:
- SEO / GEO: Odkrywanie, crawling, indeksowanie, dane strukturalne i retrieval w systemach AI.
- Product: Projektowanie ścieżek i definiowanie zadań.
- Engineering: Architektura semantyczna, kontrolki, stan i wydajność.
- Accessibility: Użyteczność dla ludzi, jakość drzewa dostępności i semantyka interakcji.
- Data / katalog: Spójność encji, ceny, stany magazynowe i warianty.
- QA: Ukończenie zadań i testy regresji.
- Zespoły komercyjne: Które ścieżki faktycznie mają znaczenie dla przychodów?
Właśnie w tym miejscu nowoczesne SEO staje się ciekawsze.
Nie chodzi o odpowiedzialność za kanał.
Chodzi o rozumienie systemu.
Czego to nie dowodzi
Istnieją istotne ograniczenia.
- Nie ma dowodów, że lepsze przystosowanie witryny do agentów bezpośrednio poprawia pozycje w Google.
- Semantyczny HTML nie jest tajnym czynnikiem rankingowym GEO.
- Zgodności z wymaganiami dostępności nie należy przedstawiać jako drogi na skróty do lepszych pozycji w systemach AI.
- Schema nie gwarantuje, że agent pomyślnie przeprowadzi transakcję.
- WebMCP to rozwijająca się technologia, a nie uniwersalny standard produkcyjny.
- Udane dodanie produktu do koszyka przez agenta nie dowodzi wzrostu przychodów, którego nie byłoby bez tej interakcji.
Te warstwy powinny pozostać rozdzielone.
Przedstawione materiały wskazują na coś bardziej praktycznego:
agenci przeglądarkowi coraz częściej korzystają z interfejsów webowych jak z działających systemów, a nie tylko źródeł treści.
To sprawia, że możliwość obsługi witryny przez maszyny staje się realnym zagadnieniem produktowym.
Moja interpretacja
SEO i GEO tradycyjnie pytały:
- Czy maszyny potrafią nas znaleźć?
- Następnie: Czy maszyny potrafią nas zrozumieć?
- Agenci AI dodają pytanie: Czy maszyny potrafią z nas korzystać?
Dla wydawcy różnica może być niewielka.
Dla dużej platformy e-commerce, marketplace’u, serwisu turystycznego czy platformy usługowej może mieć fundamentalne znaczenie.
Przyszły stos techniczny może więc wyglądać mniej więcej tak:
Możliwość crawlowania → Możliwość indeksowania → Możliwość pobierania informacji → Jednoznaczność encji → Spójność multimodalna → Możliwość obsługi przez agentów → Ukończenie zadania → Wartość biznesowa
Ostatnie przejście ma znaczenie. Widoczność w systemie AI jest użyteczna. Możliwość wykonania działania przez system AI jest znacznie bliższa handlowi.
I uważam, że właśnie w tym obszarze SEO/GEO coraz częściej musi współpracować z Product i Engineering.
Nie tylko monitorować boty.
Testować agentów.
Źródła
- Google: Optimizing for generative AI Search — Google Search Central
- Build agent-friendly websites — web.dev
- Chrome: Agent-ready website toolkit — Chrome for Developers
- WebMCP — Chrome for Developers
- OpenAI Computer Use — OpenAI Developers
- W3C: HTML controls and links — W3C WAI
Wymieńmy się doświadczeniami
Jak to wygląda w Twojej praktyce?
Która z tych zmian już wpływa na pracę Twojego zespołu? Podziel się doświadczeniem na LinkedIn lub przeczytaj powiązaną notatkę na Substacku.