Artykuł · 24.10.2026
Dostawcy AI nie mogą wiecznie polegać na cudzych wyszukiwarkach
Infrastruktura wyszukiwania staje się przewagą konkurencyjną w AI. Analiza indeksów, zależności od dostawców oraz konsekwencji dla pomiaru SEO i GEO.
W tym artykule
Infrastruktura wyszukiwania staje się kolejnym obszarem konkurencji w AI, a ograniczenia Google dotyczące automatycznego dostępu do SERP sprawiają, że zależność od cudzych wyszukiwarek jest coraz bardziej widoczna.
Dużo czasu poświęcamy porównywaniu modeli AI
Który model lepiej rozumuje? Który jest szybszy? Który ma większe okno kontekstowe? Który udziela lepszych odpowiedzi?
Ale pod tymi modelami działa jeszcze jedna warstwa konkurencji, która może stać się równie ważna:
infrastruktura wyszukiwania.
Crawlery. Indeksy. Systemy retrieval. Procesy rankingowe. API wyszukiwania. Pobieranie stron na bieżąco. Źródła danych ustrukturyzowanych.
Dla produktu AI, który potrzebuje aktualnych informacji z internetu, nie są to drobiazgi implementacyjne.
Decydują o tym, co można odkryć, jak aktualne są informacje, jak szybko można je pobrać i ostatecznie jakie dane trafią do modelu.
A niedawne zmiany w Google Search znacznie wyraźniej pokazują strategiczną wartość kontrolowania większej części tej infrastruktury.
Google utrudnia automatyczne zbieranie wyników wyszukiwania
Najpierw ważne rozróżnienie.
Google oficjalnie stwierdza, że automatyczne zapytania do Google Search, w tym scraping wyników w celu sprawdzania pozycji, naruszają zasady dotyczące spamu i warunki korzystania z usług.
Google nie mówi natomiast oficjalnie:
Celowo zwracamy narzędziom SEO fałszywe wyniki wyszukiwania.
Ta część pochodzi z obserwacji firm obsługujących infrastrukturę do zbierania SERP na dużą skalę.
A obserwacje te stają się coraz ciekawsze.
SISTRIX informuje, że od 2025 roku Google stopniowo komplikuje zbieranie wyników wyszukiwania.
Wśród opisywanych zmian są:
- usunięcie możliwości pobrania 100 wyników jednym zapytaniem
- listy wyników kończące się przed pozycją 100
- powszechne stosowanie wewnętrznych adresów przekierowań
/goto - a od września 2026 roku także zestawy wyników, które mogą znacząco różnić się od zwykłych wyników wyszukiwania
Według SISTRIX te rozbieżne SERP mogą wyglądać autentycznie, a jednocześnie zawierać inne witryny. Zanim takim danym będzie można zaufać, wymagają dodatkowej weryfikacji.
Ahrefs opisuje to samo zjawisko mocniejszym językiem.
W aktualizacji z 22 października 2026 roku Ahrefs nazwał je „zatruwaniem” wyników wyszukiwania i podał, że w zależności od dostawcy danych problem dotyczył około 5–20% obserwowanych wyników.
To określenie Ahrefs, nie Google.
Sama obserwacja ma jednak znaczenie.
Dostawcy danych SERP coraz częściej nie mogą zakładać, że pojedyncze automatyczne żądanie zwróci ten sam zestaw wyników, który zobaczyłby zwykły użytkownik.
Jest też inna zmiana infrastrukturalna.
DataForSEO informuje, że Google na szeroką skalę wdrożyło pośrednie adresy google.com/goto w wynikach organicznych. Zamiast bezpośrednio udostępniać docelowy URL, wymaga ustalenia właściwego adresu przez przejście za przekierowaniem.
DataForSEO deklaruje, że musiało zbudować infrastrukturę do ustalania adresów docelowych i obecnie ustala bezpośrednie adresy dla 99,99% organicznych SERP objętych tą zmianą.
SISTRIX jasno wskazuje skutek biznesowy: ustalanie tych zamaskowanych adresów oznacza dodatkowe żądania, dodatkowe przetwarzanie i dodatkowe koszty.
Żadna z tych zmian nie uniemożliwia zbierania SERP.
Sprawiają jednak, że staje się ono droższe, mniej przewidywalne i bardziej złożone operacyjnie.
A to ma znaczenie daleko wykraczające poza narzędzia SEO.
Dostęp do wyszukiwania oznacza zależność
Wyobraźmy sobie budowę produktu AI, którego użyteczność zależy od aktualnych informacji z internetu.
Potrzebujemy:
- szerokiego pokrycia zasobów internetu
- aktualnych dokumentów
- przewidywalnych opóźnień
- wiarygodnych adresów URL
- wyodrębniania treści na odpowiednim poziomie szczegółowości
- rankingu i rerankingu
- ustrukturyzowanych metadanych
- wysokiej dostępności
- przewidywalnych kosztów
Jeśli cała warstwa retrieval zależy od wyszukiwarki innej firmy, przejmujemy związane z nią zasady, zmiany techniczne, ceny, opóźnienia i ograniczenia dostępu.
Nie oznacza to, że zewnętrzne API wyszukiwania są złym rozwiązaniem.
Oznacza to, że są zależnością.
W przypadku małych aplikacji ta zależność może być całkowicie racjonalna.
Dla firm, które chcą budować fundamentalne produkty AI Search, staje się kwestią strategiczną.
Perplexity już przekroczyło tę granicę
Perplexity jest prawdopodobnie najbardziej wyrazistym przykładem.
Jego zespół inżynieryjny opisał, dlaczego istniejące API wyszukiwania nie wystarczały systemowi retrieval projektowanemu z myślą o AI.
Według Perplexity tradycyjne API były zbyt drogie, zbyt wolne, zbyt mało aktualne lub oferowały niewystarczającą szczegółowość dla sposobów pobierania informacji wymaganych przez systemy AI.
Wniosek był prosty:
potrzebna była dedykowana infrastruktura wyszukiwania.
To już nie jest niewielki eksperyment z crawlerem.
Perplexity podaje, że jego indeks wyszukiwania obejmuje ponad 200 miliardów unikalnych adresów URL, a zbudowany system crawlowania i indeksowania działa w skali eksabajtów.
Jego architektura łączy:
- indeksowanie rozproszone
- retrieval leksykalny
- retrieval semantyczny
- ranking wieloetapowy
- pobieranie informacji na poziomie dokumentu
- pobieranie informacji na poziomie fragmentów dokumentu
- ustalanie priorytetów crawlowania z wykorzystaniem uczenia maszynowego
- optymalizację aktualności danych
Najważniejsze nie jest to, czy Perplexity odtworzyło Google.
Przywołany opis techniczny nie dowodzi, że tak się stało.
Istotne jest to, że kontrola nad warstwą retrieval stała się na tyle ważna strategicznie, by uzasadnić budowę infrastruktury.
OpenAI również buduje własną warstwę wyszukiwania
OpenAI dostarcza kolejnego przydatnego przykładu, ale dowody trzeba interpretować ostrożnie.
OpenAI używa OAI-SearchBot, crawlera związanego konkretnie z wyszukiwaniem.
Dokumentacja podaje, że OAI-SearchBot służy do wyświetlania witryn w ChatGPT Search, a jego zablokowanie może uniemożliwić pojawianie się treści w odpowiedziach wyszukiwania ChatGPT.
To inna funkcja niż GPTBot, który jest związany z rozwojem modeli.
OpenAI dokumentuje też już wprost własny indeks wyszukiwania.
W przypadku przestrzeni roboczych ChatGPT kwalifikujących się do użycia zgodnego z HIPAA OpenAI podaje, że Web Search i Deep Research korzystają z informacji z własnego indeksu OpenAI i nie wysyłają zapytań do zewnętrznych dostawców wyszukiwania, takich jak Bing.
W innym miejscu OpenAI stwierdza, że ChatGPT Search nadal może współpracować z zewnętrznymi dostawcami wyszukiwania. Obecna dokumentacja wymienia wśród nich Microsoft.
To rozróżnienie ma znaczenie.
Uzasadnionym wnioskiem nie jest:
OpenAI zastąpiło Bing własną uniwersalną wyszukiwarką.
Dowody wspierają ciekawszy wniosek:
OpenAI może korzystać zarówno z własnej, jak i zewnętrznej infrastruktury wyszukiwania, zależnie od produktu i środowiska
To architektura hybrydowa.
OpenAI opisało również utrzymywanie niezależnego indeksu internetu w innym celu: sprawdzania, czy adresy URL są już publicznie znane, zanim agent automatycznie uzyska do nich dostęp.
To nie jest to samo co indeks służący do rankingu wyników wyszukiwania, ale stanowi kolejny dowód, że utrzymywanie infrastruktury odkrywania zasobów w skali internetu ma wartość wykraczającą poza generowanie list linków.
Anthropic pokazuje inny wariant tej samej architektury
Anthropic również rozdziela systemy dostępu do internetu.
Obecna dokumentacja crawlerów wymienia trzech odrębnych agentów:
- ClaudeBot do rozwoju modeli.
- Claude-User do pobierania treści inicjowanego przez użytkownika.
- Claude-SearchBot do wyszukiwania.
Anthropic podaje, że Claude-SearchBot przegląda internet, aby poprawiać jakość wyników wyszukiwania, a jego zablokowanie uniemożliwia Anthropic indeksowanie treści na potrzeby optymalizacji wyszukiwania.
Ponownie: samo crawlowanie nie oznacza automatycznie, że Anthropic prowadzi kompletny, niezależny indeks wyszukiwania na wzór Google.
Nie powinniśmy wnioskować więcej, niż wynika z dokumentacji.
Jednocześnie Anthropic korzysta też z zewnętrznej infrastruktury wyszukiwania.
Dokumentacja Google Cloud dotycząca wyszukiwania internetowego Claude wymienia obecnie Brave Search jako zewnętrznego dostawcę wyszukiwania używanego przez Anthropic w tym środowisku.
Po raz kolejny architektura okazuje się więc bardziej złożona niż:
jeden dostawca AI = jedna wyszukiwarka.
Może łączyć własne crawlowanie, zewnętrznych dostawców wyszukiwania i bezpośrednie pobieranie stron.
Brave czyni niezależność produktem
Brave ma tu znaczenie strategiczne, ponieważ jego Search API opiera się na własnym indeksie internetu.
Brave wprost deklaruje, że jego API nie korzysta awaryjnie z Google ani Bing, a wyniki pochodzą z niezależnie crawlowanego indeksu z własnym rankingiem.
Ta propozycja zyskuje na wartości, gdy dostęp do innych wyszukiwarek staje się mniej przewidywalny.
Brave sprzedaje w praktyce coś więcej niż wyniki wyszukiwania.
Sprzedaje niezależność od dostępu do wyszukiwarek dostawców zewnętrznych.
To ciekawa pozycja infrastrukturalna w ekosystemie AI, w którym agenci mogą wykonywać dziesiątki zapytań wyszukiwania podczas jednego zadania.
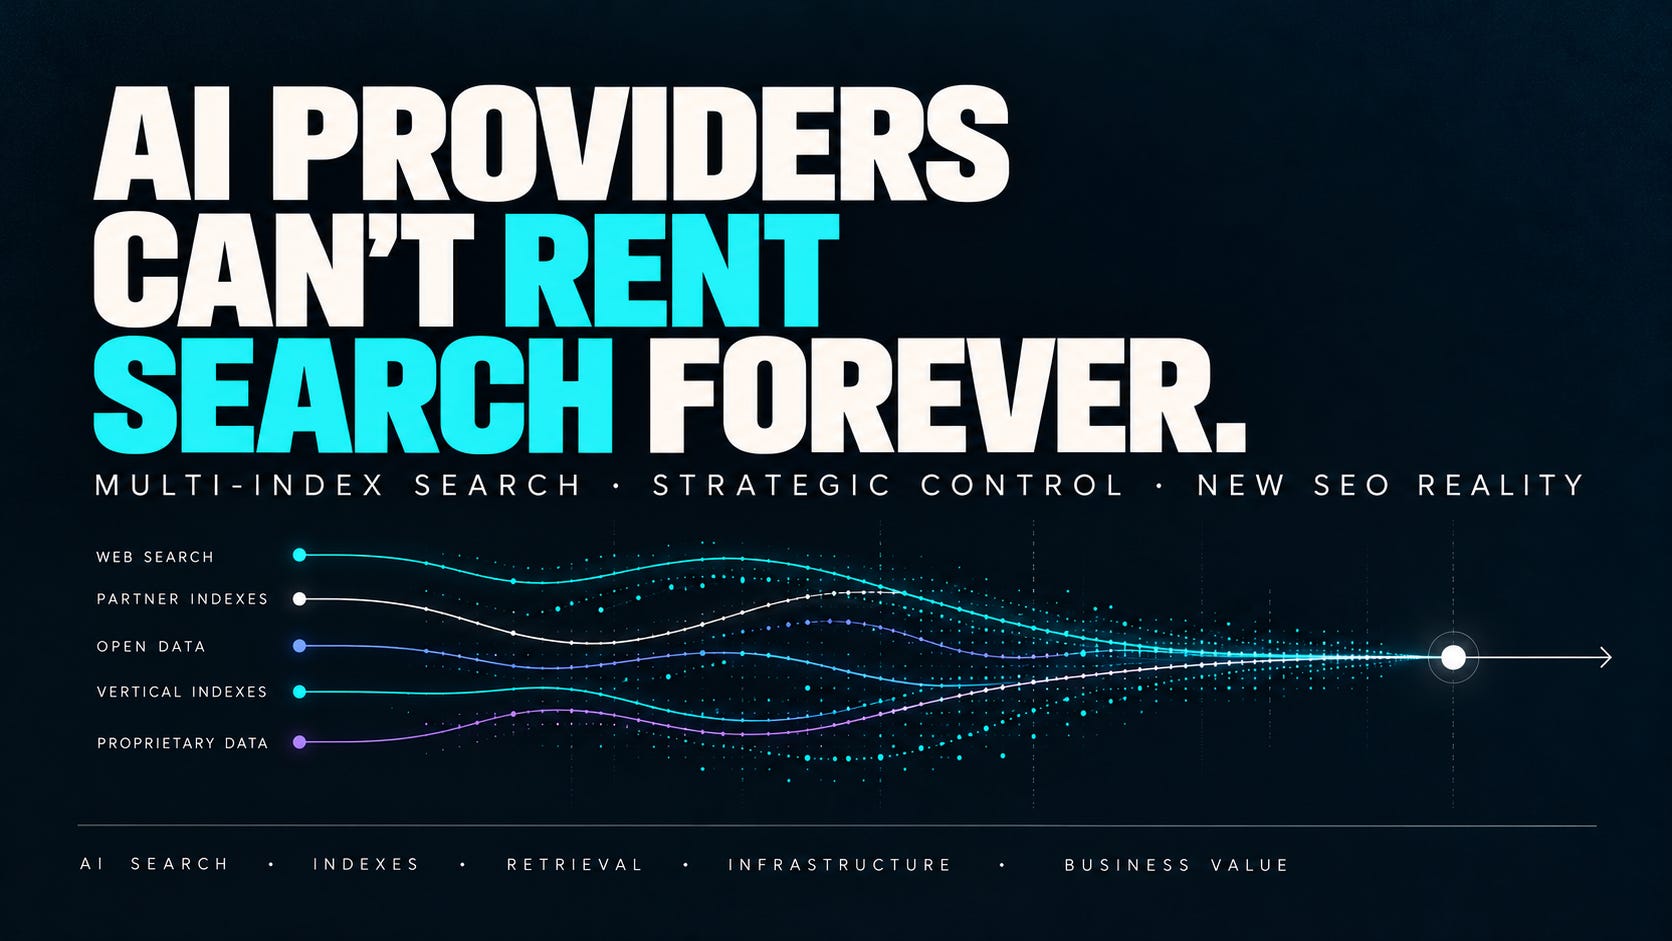
AI Search coraz częściej korzysta z wielu indeksów
Prowadzi to do wniosku, który uważam za ważniejszy z perspektywy SEO i GEO.
Powinniśmy przestać wyobrażać sobie AI Search jako:
LLM + wyniki Google.
Wyłaniająca się architektura bardziej przypomina połączenie:
- własnego crawlera
- własnego indeksu
- Bing
- Brave
- zewnętrznych dostawców
- pobierania stron na bieżąco
- feedów produktowych
- ustrukturyzowanych baz danych
- wyspecjalizowanych źródeł branżowych
- warstw retrieval i rerankingu
Różne produkty mogą łączyć te elementy na różne sposoby.
Nawet ten sam dostawca może używać różnych architektur zależnie od produktu, geografii, konfiguracji dla przedsiębiorstwa czy wymogów zgodności.
Oznacza to, że AI Search coraz częściej staje się systemem korzystającym z wielu indeksów.
Nie dlatego, że każda firma AI próbuje odtworzyć Google.
Dlatego, że kontrola nad większą częścią infrastruktury odkrywania i pobierania informacji daje dostawcom strategiczne korzyści.
Dlaczego własna infrastruktura wyszukiwania ma znaczenie
Jest kilka oczywistych powodów.
1. Aktualność
Systemy AI odpowiadające na pytania o aktualne informacje potrzebują niedawno zaktualizowanych informacji.
Dostawca kontrolujący własnego crawlera i harmonogram odświeżania może decydować, które dokumenty wymagają częstego ponownego crawlowania, zamiast przyjmować częstotliwość aktualizacji narzuconą przez inne API.
2. Opóźnienia
Wyszukiwanie jest często jednym z etapów znacznie dłuższego procesu realizowanego przez agenta.
Gdy agent wykonuje wiele wyszukiwań, setki milisekund zaczynają mieć znaczenie.
Dodatkowe wywołania API, przekierowania i warstwy retrieval mogą szybko kumulować opóźnienia.
3. Jakość retrieval
Tradycyjne wyszukiwarki optymalizowano przede wszystkim pod kątem zwracania wyników ludziom.
Systemy AI potrzebują czegoś innego.
Mogą potrzebować:
- mniejszych fragmentów treści
- fragmentów spójnych znaczeniowo
- informacji na poziomie encji
- ustrukturyzowanych atrybutów
- pobierania szerokiego zbioru kandydatów z wysokim recall, a następnie intensywnego rerankingu
Właśnie z tego powodu Perplexity wprost opisuje pobieranie informacji i ustalanie rankingu zarówno na poziomie dokumentów, jak i ich fragmentów.
4. Koszt
Korzystanie z API wyszukiwania przy dużej liczbie zapytań szybko staje się kosztowne.
W skali AI własna infrastruktura może przestać być inżynieryjnym luksusem, a stać się decyzją ekonomiczną.
5. Dostępność i ryzyko zmiany zasad
Dostawca, od którego zależy system, może zmienić:
- API
- ceny
- parametry
- limity zapytań
- mechanizmy przeciwdziałania automatyzacji
- sposób prezentacji wyników
- zasady dostępu
Niedawne zmiany Google dobrze pokazują ryzyko takiej zależności.
Ponownie: nie dowodzą, dlaczego firmy AI zaczęły budować indeksy.
Wzmacniają jednak argument za taką inwestycją.
Co to oznacza dla SEO i GEO
Ta architektura zmienia moje podejście do pomiaru widoczności.
Pozycja w Google jest przydatna.
Nie jest jednak uniwersalnym wskaźnikiem zastępczym widoczności w AI.
Adres URL może:
- zajmować wysoką pozycję w Google
- być słabo reprezentowany w innym indeksie
- być często odwiedzany przez bota AI
- nigdy nie zostać pobrany na potrzeby odpowiedzi na istotne prompty
- zostać pobrany, ale nie zacytowany
- zostać zacytowany, ale nie otrzymać ruchu z odesłań
- otrzymać ruch z AI, który nie przyniesie dodatkowej wartości biznesowej
To różne etapy.
W modelach pomiarowych powinny pozostać odrębne.
W enterprise SEO/GEO rozdzieliłbym:
Crawlowanie → indeksowanie → retrieval → ranking → cytowanie → odesłanie → transakcja
I osobno monitorowałbym odpowiednie rodziny crawlerów.
Na przykład w przypadku OpenAI:
OAI-SearchBot nie jest tym samym sygnałem co GPTBot.
W przypadku Anthropic:
Claude-SearchBot nie jest tym samym sygnałem co ClaudeBot.
Wzrost aktywności crawlerów nie oznacza więc automatycznie poprawy widoczności w AI.
A poprawa widoczności w AI nie oznacza automatycznie dodatkowego przychodu.
Model operacyjny też powinien się zmienić
Długoterminowa szansa nie sprowadza się do kolejnego dashboardu widoczności w AI.
Wolałbym połączyć kilka warstw analitycznych w jeden model operacyjny.
Dla każdego adresu URL, produktu, sprzedawcy, kategorii lub rynku:
- Warstwa crawlerów
- Które boty uzyskały dostęp?
- Jakie kody statusu otrzymały?
- Czy dostęp blokowały robots.txt, reguły CDN lub konfiguracja WAF?
- Warstwa wyszukiwania
- Czy URL jest zaindeksowany?
- Jaką zajmuje pozycję?
- Jak duży jest popyt w tradycyjnym wyszukiwaniu?
- Warstwa AI Search
- Czy encja jest wzmiankowana?
- Czy URL jest cytowany?
- Dla jakich promptów i scenariuszy?
- Czy otrzymuje ruch z odesłań z AI?
- Warstwa biznesowa
- Czy te wizyty prowadzą do konwersji?
- Czy generują zamówienia, GMV, przychód lub marżę?
- Warstwa katalogu
- Jaki produkt, ofertę, sprzedawcę, kategorię i rynek reprezentuje URL?
Daje to znacznie mocniejsze wspólne źródło prawdy, czyli Single Source of Truth.
Nie dlatego, że w magiczny sposób dowodzi przyczynowości.
Nie dowodzi.
Pozwala jednak zespołom diagnozować problemy, wykrywać anomalie i ustalać priorytety prac inżynieryjnych oraz treściowych z uwzględnieniem kontekstu biznesowego.
Czego dowody nie potwierdzają
Kilku twierdzeń wyraźnie bym unikał.
Ograniczenia Google dotyczące SERP nie dowodzą, że OpenAI, Anthropic czy Perplexity zbudowały infrastrukturę crawlowania z powodu Google.
Te inwestycje rozpoczęły się z różnych powodów i w różnym czasie.
Claude-SearchBot nie dowodzi, że Anthropic prowadzi całkowicie niezależną globalną wyszukiwarkę.
OAI-SearchBot nie oznacza, że każda odpowiedź ChatGPT Search pochodzi w całości z własnego indeksu OpenAI.
Własny crawler nie oznacza automatycznie pełnej niezależności indeksu.
A więcej crawlowania nie oznacza większej liczby cytowań.
Dowody wspierają węższy, ale strategicznie mocniejszy wniosek:
Dostawcy AI coraz bardziej potrzebują kontroli nad odkrywaniem, indeksowaniem i pobieraniem informacji.
- Może to oznaczać własny indeks.
- Może oznaczać łączenie kilku indeksów.
- Może oznaczać współpracę z niezależnymi dostawcami, takimi jak Brave.
- Najprawdopodobniej oznacza wszystkie te rozwiązania jednocześnie.
Szersze pole konkurencji
Wyścig AI zwykle przedstawiamy jako:
model kontra model.
Moim zdaniem takie ujęcie staje się niepełne.
Kolejną warstwą konkurencji może coraz częściej być:
- indeks kontra indeks
- infrastruktura retrieval kontra infrastruktura retrieval
- infrastruktura crawlerów kontra infrastruktura crawlerów
- ekosystem danych kontra ekosystem danych
Modele nadal mają ogromne znaczenie.
Ale model może rozumować tylko na podstawie informacji, które do niego docierają.
To sprawia, że infrastruktura wyszukiwania staje się częścią produktu.
Dla zespołów SEO i GEO oznacza to, że ekosystem wyszukiwania staje się bardziej rozdrobniony, a nie mniej.
Może już nie być jednego indeksu, pod który można optymalizować i traktować go jako wskaźnik zastępczy wszystkiego innego.
Przyszłość znacznie bardziej przypomina sieć crawlerów, indeksów, feedów, API i systemów retrieval.
AI Search coraz częściej korzysta z wielu indeksów.
A to zmienia zarówno sposób optymalizacji, jak i pomiaru.
Źródła
- OpenAI Crawlers — developers.openai.com/api/docs/bots — Definiuje OAI-SearchBot i jego rolę w ChatGPT Search.
- OpenAI Search Index / HIPAA — help.openai.com/en/articles/20001069 — Dokumentuje wykorzystanie własnego indeksu wyszukiwania OpenAI w środowiskach kwalifikujących się do użycia zgodnego z HIPAA.
- Searching the web with ChatGPT — help.openai.com/en/articles/9237897 — Dokumentuje korzystanie przez ChatGPT z zewnętrznych dostawców wyszukiwania.
- OpenAI: AI agent link safety — openai.com/index/ai-agent-link-safety — Opisuje niezależny indeks internetu służący do weryfikacji publicznych adresów URL.
- Anthropic Crawlers — support.claude.com/en/articles/8896518 — Definiuje ClaudeBot, Claude-User i Claude-SearchBot.
- Claude Web Search on Google Cloud — docs.cloud.google.com/gemini-enterprise-agent-platform/models/partner-models/claude/web-search — Wskazuje Brave Search jako zewnętrznego dostawcę w tym środowisku.
- Perplexity: Architecting and Evaluating an AI-First Search API — perplexity.ai/hub/blog/architecting-and-evaluating-an-ai-first-search-api — Szczegółowo opisuje infrastrukturę crawlowania, indeksowania, retrieval i rankingu Perplexity.
- Brave Search API — brave.com/search/api — Dokumentuje niezależnego crawlera i indeks Brave.
- Google Search Spam Policies — developers.google.com/search/docs/essentials/spam-policies — Określa zasady Google dotyczące automatycznych zapytań i ruchu związanego ze sprawdzaniem pozycji.
- Ahrefs: Google SERP Data Update — ahrefs.com/blog/serp-data-update — Opisuje rozbieżne wyniki wpływające na dostawców danych SERP.
- SISTRIX: Why Google ranking data collection is changing — sistrix.com/support/google-ranking-data-collection — Dokumentuje rozbieżne wyniki, przekierowania
/gotoi ograniczony dostęp do dalszych stron wyników. - DataForSEO: Google’s /goto rollout — dataforseo.com/update/googles-goto-rollout — Dokumentuje adresy przekierowań Google i warstwę ustalania adresów docelowych DataForSEO.
Wymieńmy się doświadczeniami
Jak to wygląda w Twojej praktyce?
Która z tych zmian już wpływa na pracę Twojego zespołu? Podziel się doświadczeniem na LinkedIn lub przeczytaj powiązaną notatkę na Substacku.